用 文字 拍一部黑色电影
Higgsfield 短片全流程精读
我把 Higgsfield 官方社区里那篇约 9 分钟、含 36 条原始提示词、4 个可下载 Skill 的工作流长文逐段读完了。这份报告不复述它,而是把它拆成你能直接照着做的工序:资产怎么造、提示词怎么写、镜头怎么保连贯、接缝怎么藏、表演怎么不"死眼"。
01三分钟看懂全片流程
先别急着写提示词。这篇文章真正值钱的地方,是它把"AI 生成视频"从抽卡,改成了一条有工序的流水线:资产 → 分镜 → 生成 → 补拍 → 剪辑。
"我做这部短片的方法:先把角色、场景、道具做成可复用的资产;再用一段段手写的分镜提示词,把它们拼成镜头。"
片子叫 《ALLERGIC》:白化病杀手 Adam 接一单活,一路杀进夜店、走廊,最后走进吸血鬼老大 Victor 的书房,把话说完、把人打死,然后回到老 Ron 的办公室交出这单活,说"我不干了"。全片黑色犯罪质感,21:9,几乎每个镜头段都是 20~30 秒的多镜头序列。
这条流程和"直接写一句话抽视频"差在哪
① 资产先于镜头
角色的脸、大衣、链子、声音先被"固化"成一张图和一段约 10 秒的表演视频。之后 30 多个镜头全部用 @char_adam_video_v1 引用同一个人。身份不靠祈祷,靠引用。
② 提示词是施工图
不是"一个帅气的男人走在雨夜街头"。是"0–5 秒、35mm、离地 0.3 米、从右后方 3/4 角、推镜、硬切、雨是背光的"。可执行、可复现、可局部修改。
③ 表演与打斗是结构
"让眼神有戏"没用。要给眼睛一个任务:在对方两只眼睛里找一点信任的火花。要写死 Goal / Obstacle / Tactic,演员才活得起来。
谁负责什么:Claude 与 Higgsfield 的分工
| 角色 | 干什么 | 产出物 |
|---|---|---|
| 你 | 定故事、定调性、选 take、做剪辑判断。所有"这镜头要不要"的决定权。 | 剧本、镜头清单、最终剪辑 |
| Claude(装 Skill) | 把"这里要发生什么"扩写成符合 15 段骨架的分镜提示词;用五要素引擎审结构;写表演任务块。 | 可直接粘贴的提示词文本 |
| Higgsfield | 跑图(GPT Image 2.5 / Seedream 5.0 Pro / Soul Cinema)、跑视频、管理 Elements、Canvas 画走位、Forward Extend 续拍。 | 角色图、空景板、视频片段 |
02先统一语言:14 个词
下面这些词在原文里反复出现,含义和中文社区里的用法不完全一样。先把它们钉死,后面读起来就顺了。
| 词 | 在这套工作流里的确切含义 |
|---|---|
| Element(元素) | Higgsfield 里被命名、可被 @ 引用的资产。分图像元素和视频元素。角色、地点、道具都能做成元素。 |
| 视频元素 | 用一张定妆图 + 一段真人录音,生成约 10 秒的"活人参考":脸在动、嘴在说话。它比单张图更能锁住身份和嗓音。 |
| 图像元素 | 静态参考:伤口位置、变形后的狼人形态、道具形状、地点空景。 |
| @ 命名 | 统一命名法:@char_名字_video_v1、@loc_地点_v1、@prop_道具。Claude 和 Higgsfield 里必须用同一套名字,否则 AI 不知道你在说谁。 |
| 空景板(plate) | 没有人、没有动作的干净环境图。只负责布局、材质、光源。动作交给提示词,不交给图。 |
| take(条) | 一次生成的成片片段。一条提示词通常产出 1~3 条可用素材,剪辑时挑。 |
| ACTIVE REFERENCES | 提示词开头的一节,逐个声明本镜头用到的元素和它负责什么(脸/布局/光/道具)。 |
| LIGHT LOCK | 光锁。把光源位置、色温、对比写死,禁止任何镜头"重新打光"。跨镜头统一的命根子。 |
| IDENTITY LOCK | 身份锁。多人同框时逐个写死"谁是谁、脸不能混",防止 AI 把两个角色融合成一张脸。 |
| LOCATION MAP | 空间地图。用文字描述房间朝向、谁坐哪、摄影机在哪一侧 —— 相当于文字版机位图。 |
| OPTICS | 光学。用视场角(度)而不是毫米写焦段,并规定"一个镜头内焦段锁死"。 |
| ACTION TIMING | 时间轴。用 0–5s / 5–9s 这种时间码把 30 秒切成镜头,每个 CUT 里写首帧、动作、台词、切点。 |
| POSITIVE CONSTRAINTS | 正向约束。不写"不要出现 X",而是写"画面里只有 Y"。因为负面词常把 X 召唤出来。 |
| Forward Extend | 续拍。选中一条视频,让它从最后一帧往后接着演 10 秒,用来补完动作收尾。 |
@char_adam_video_v1,Claude 写出来的提示词就会指向一个不存在的引用 —— 生成时模型只能自由发挥。
03造人:把演员"造"出来
整个流程里最反直觉的一步是:先花最多时间做一个不会动的人。因为所有人物的稳定性,都来自这张图。
3.1 一张照片 → 双联画角色板(GPT Image 2.5)
作者拿自己的照片当起点。关键不是"生成一个帅男人",而是把照片里的五官结构保住,把其他一切改掉。他用的第一句话就是身份锁:
// 角色板 · 身份锁起手式(中文意译,可直接用于中文提示词)
把附带的照片当作这张脸严格的身份参考:骨相、脸型、眼睛、鼻子、嘴唇、
胡子形状、发型走向、五官比例,必须一眼认出是同一个人。
在此基础之上,按下面的描述把脸推得更硬、更粗粝;
他的肤色、发色、身高、体型与参考图不同 —— 按描述重建,
参考图里那个人的深色头发和肤色不出现在结果里。然后是版式。注意这段写得像摄影指导的场记单,而不是"美术描述":
同一位年轻男子的两张棚拍照片,左右并置成一张电影角色设定板,
铺在同一块连续的、平整无缝的冷调浅灰背景上,两格之间留一道干净细缝。
左边是全身照(50mm、胸口高度、头顶留一点空间、大衣下摆完整入画、
靴子下方有柔和的影子);右边是头肩近景(85mm、与眼齐平、
从发顶上方一点到上胸、浅景深、双眼最实、每只眼里一枚锐利的高光)。
两格由同一盏前左方硬光照明,阴影边缘干脆,远侧脸深落。
黑色皮革要拍得厚重、不溢出不压死。调色:70% 黑色皮革与洗旧黑棉、
18% 冷中性灰背景、12% 苍白肤色 + 白发 + 白腰带 + 抛光银饰作为画面最亮值。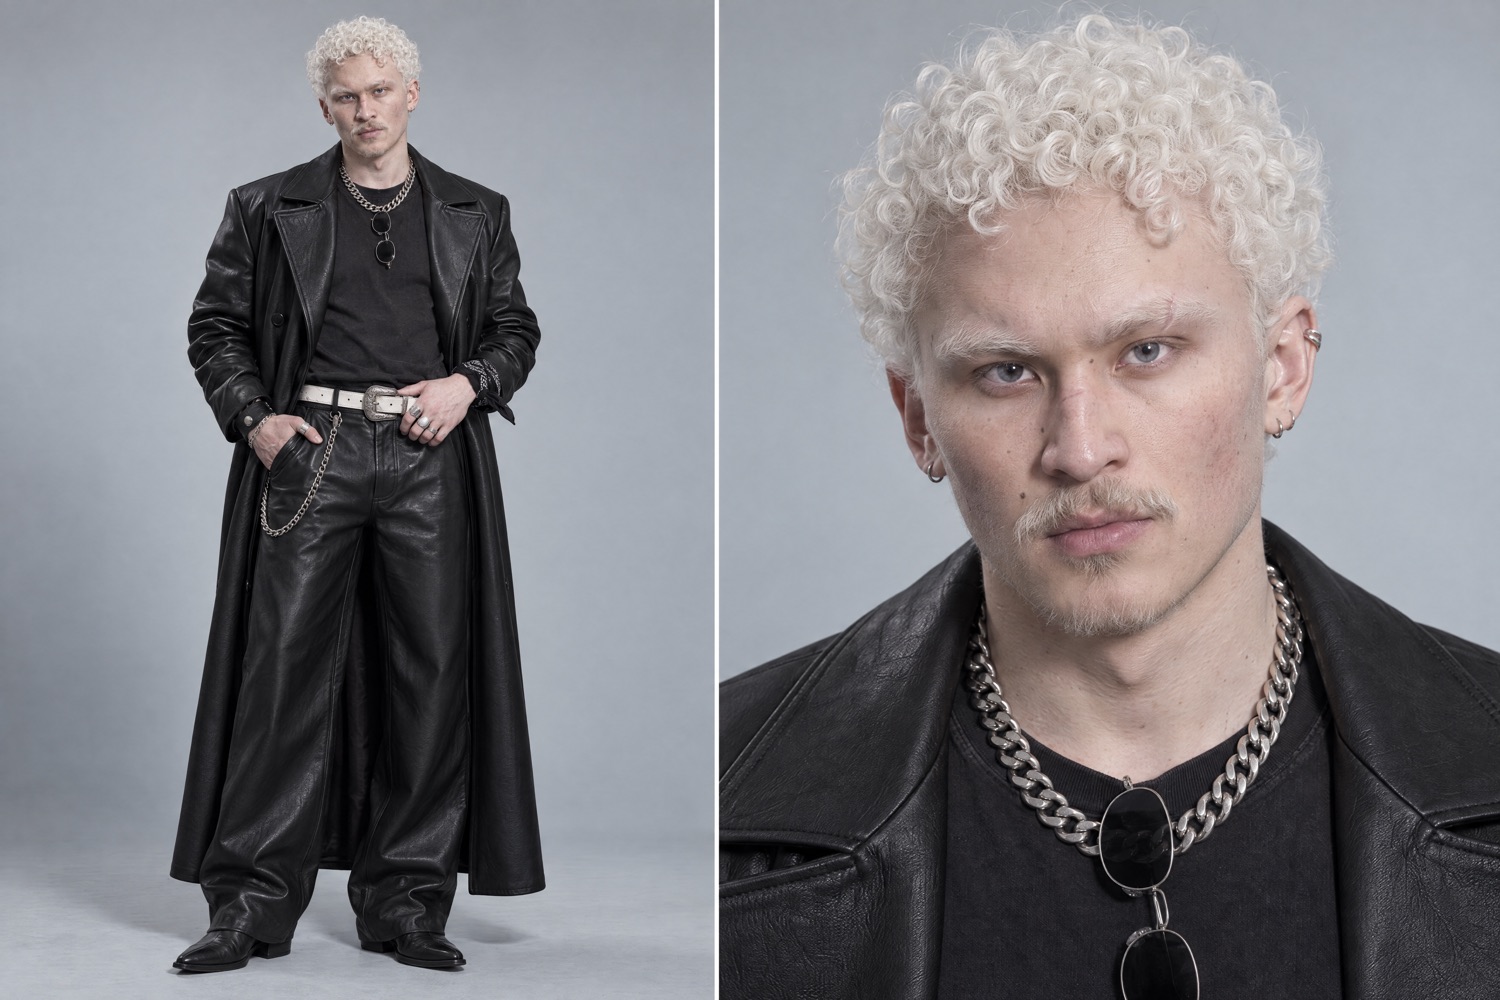
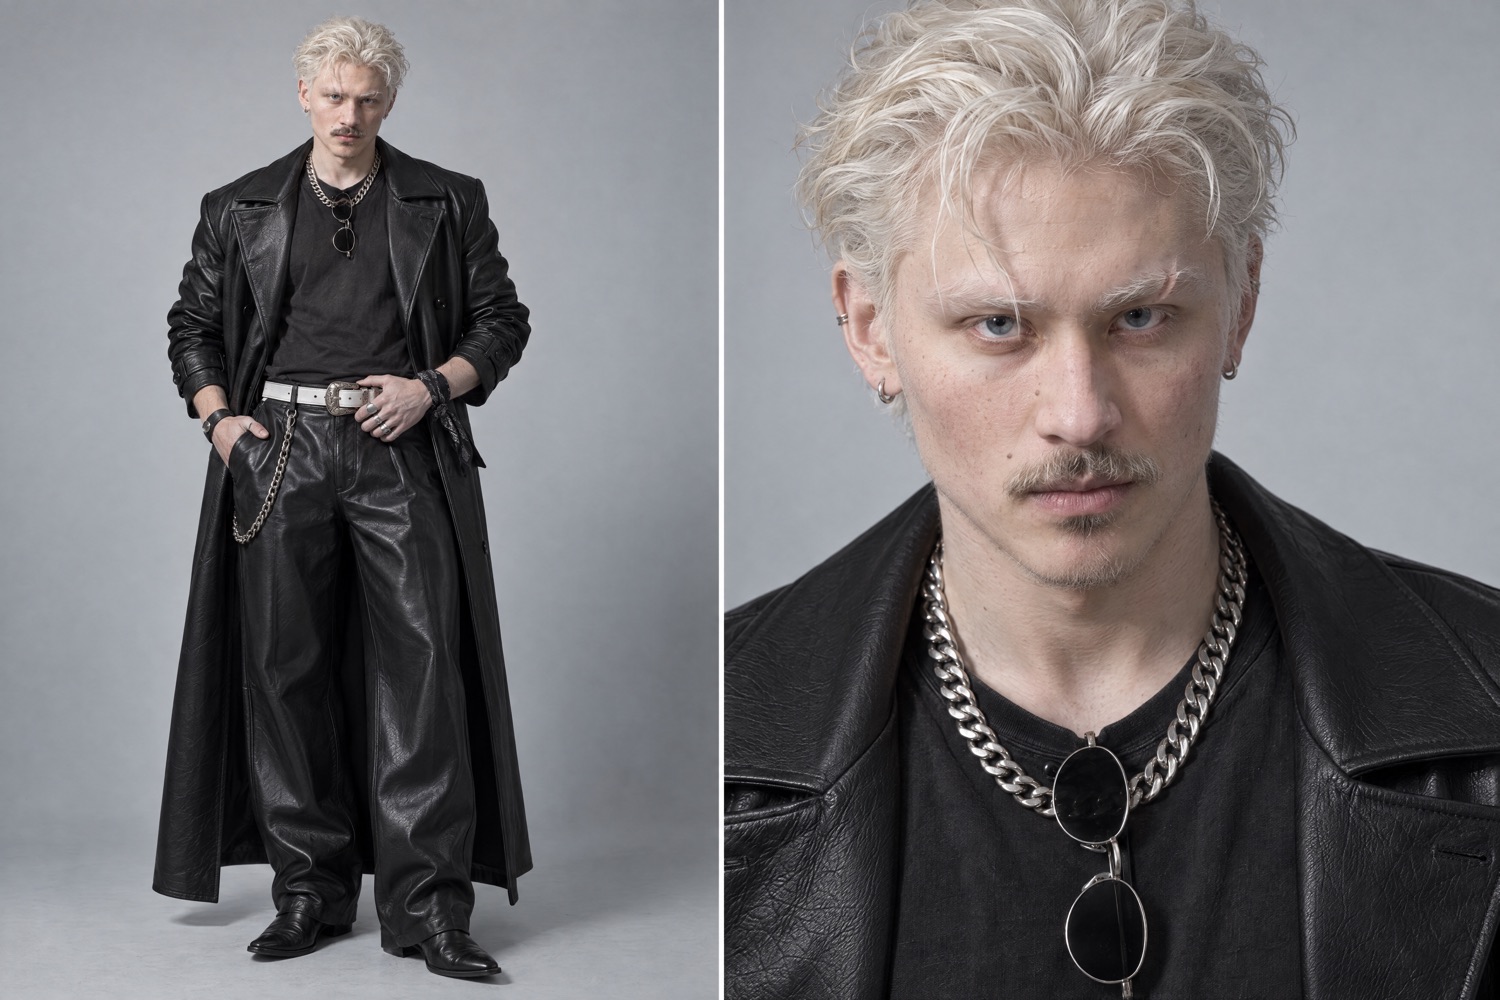
3.2 去"AI 味":纹理精修(Seedream 5.0 Pro)
设计稿一旦确定,作者会再做一遍只修表面、不动结构的精修。做法很聪明:一次挂 4~5 张"单一职责"的纹理参考图,每张只负责一件事。
| 参考 | 负责什么 |
|---|---|
@image_1 | 已通过的角色板(保结构) |
@image_2 | 发丝纹理 |
@image_3 | 皮肤纹理(毛孔、粗糙度) |
@image_4 | 背景材质 |
@image_5 | 黑色 T 恤的布料 |
只在右格上,把这个人做成一张细节极密的半身肖像照 —— 皮肤和头发都要看得清。
头发纹理取自 @图片 3,皮肤纹理取自 @图片 4,背景材质取自 @图片 5,
黑色 T 恤的布料取自 @图片 6。左格保持完全不变。
不要改变脸型、发型轮廓、服装剪裁和画面版式。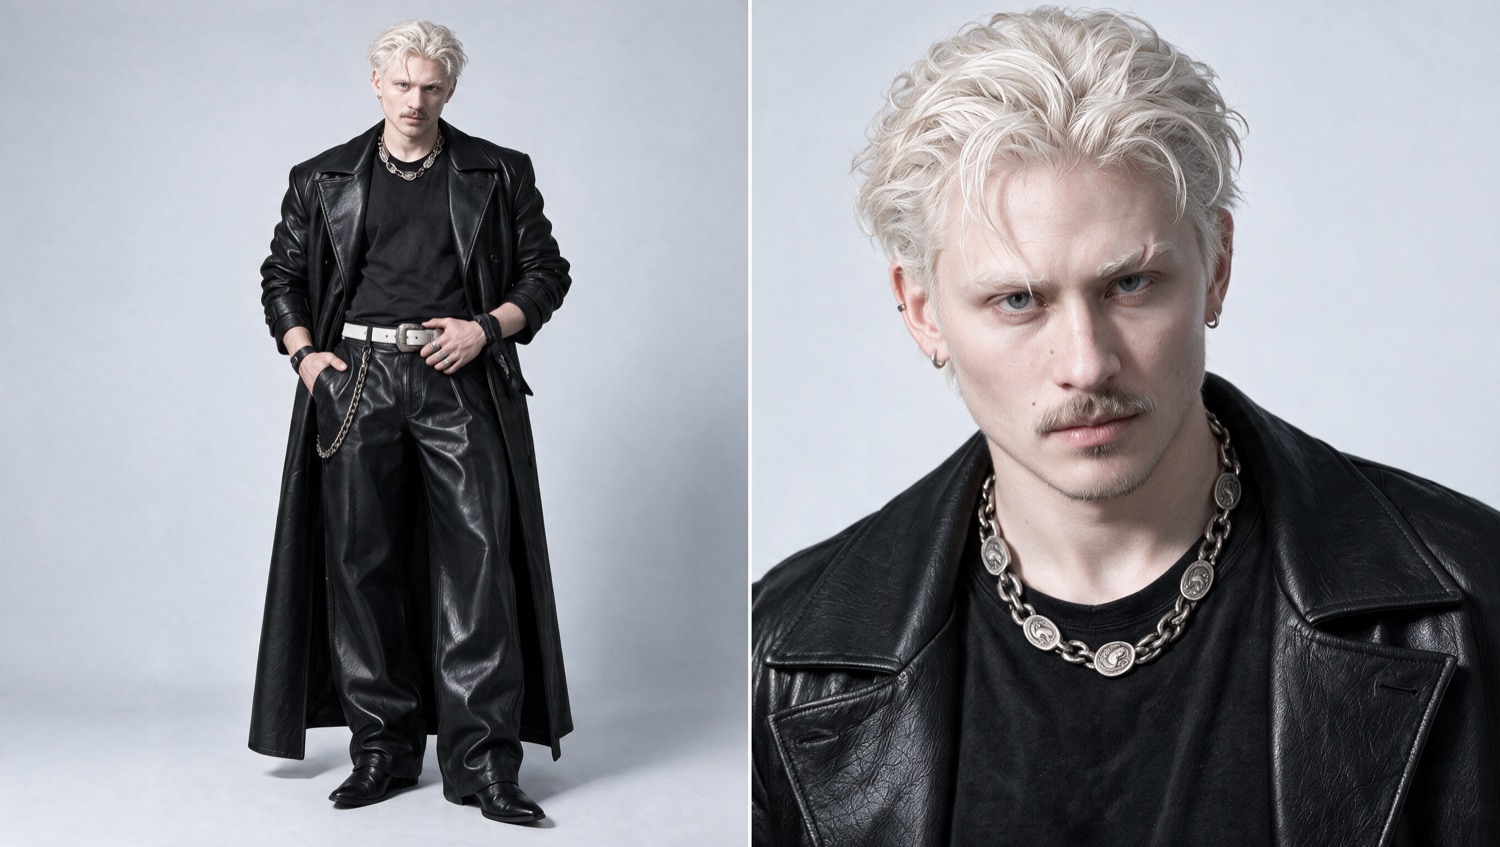
② 明确"只改哪一格":只在右格修改,左格不动 —— 否则模型会顺手把整张图重画。
3.3 反派要"选角",不走生成
Victor 不是凭空生成的。作者用 Higgsfield 的 AI Cast 先刷了一批脸,挑出符合角色的一张,再以这张定妆照作为视频元素的起点。
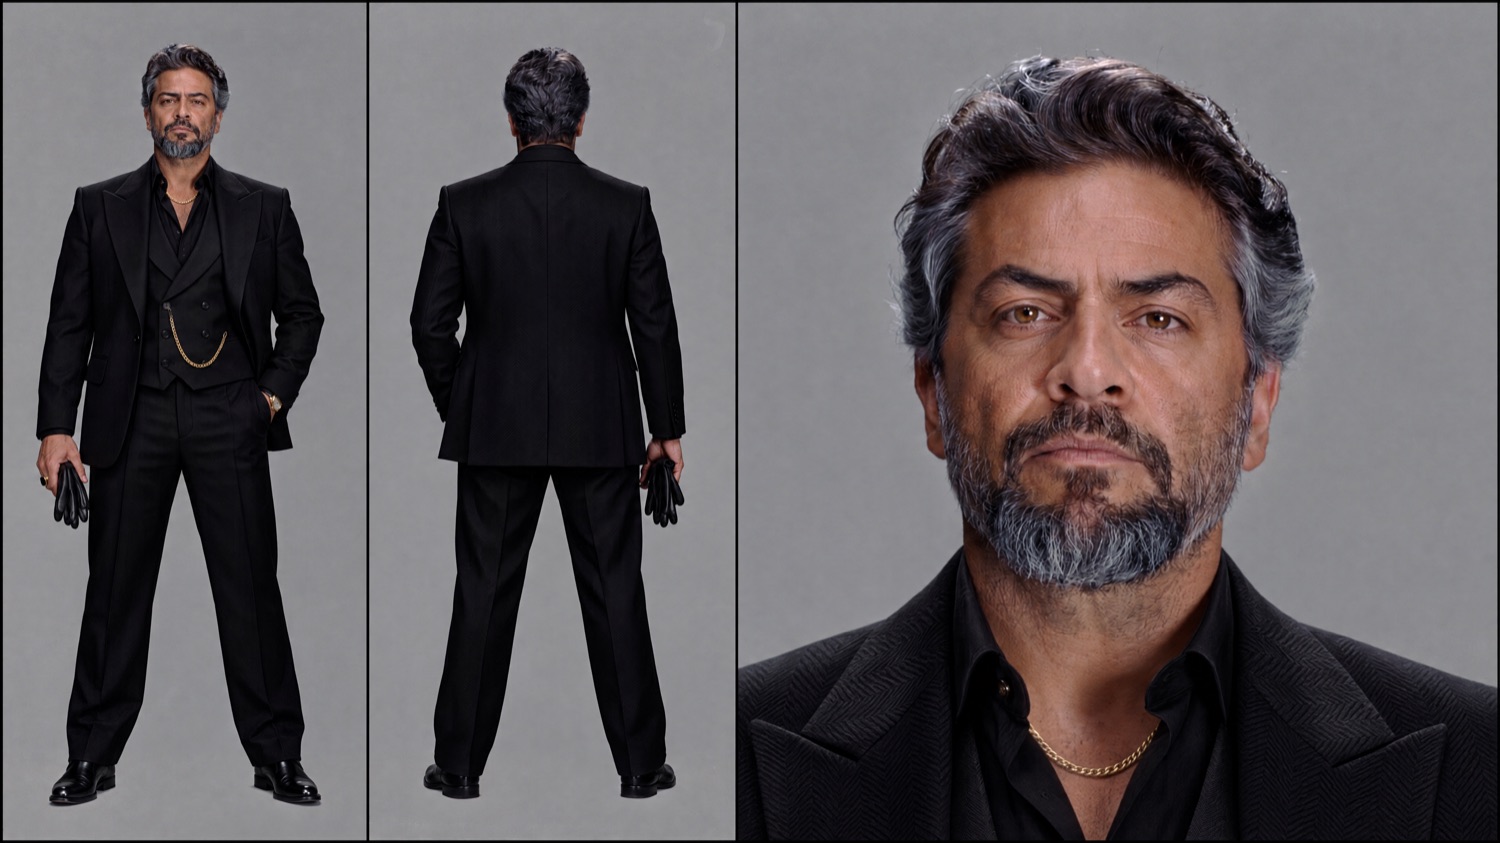
为什么"选角"比"生成"更省力
生成是求一个解;选角是从一百个解里挑一个。当角色的核心是"气质"而不是"设定"时,先刷脸再挑,比反复调提示词去逼近某个气质快得多。
挑中之后,这张图的唯一工作就是:当身份锚。它不进任何镜头,只被引用。
3.4 老大 Ron:用 Soul Cinema 出三联画
Ron 是"胖猫式的黑帮老板"。作者用 Soul Cinema 生成三联画(左全身 / 中景 / 近景),中性无缝灰底、均匀光,目的是拿一张能同时读到体型、坐姿、面部的角色板。
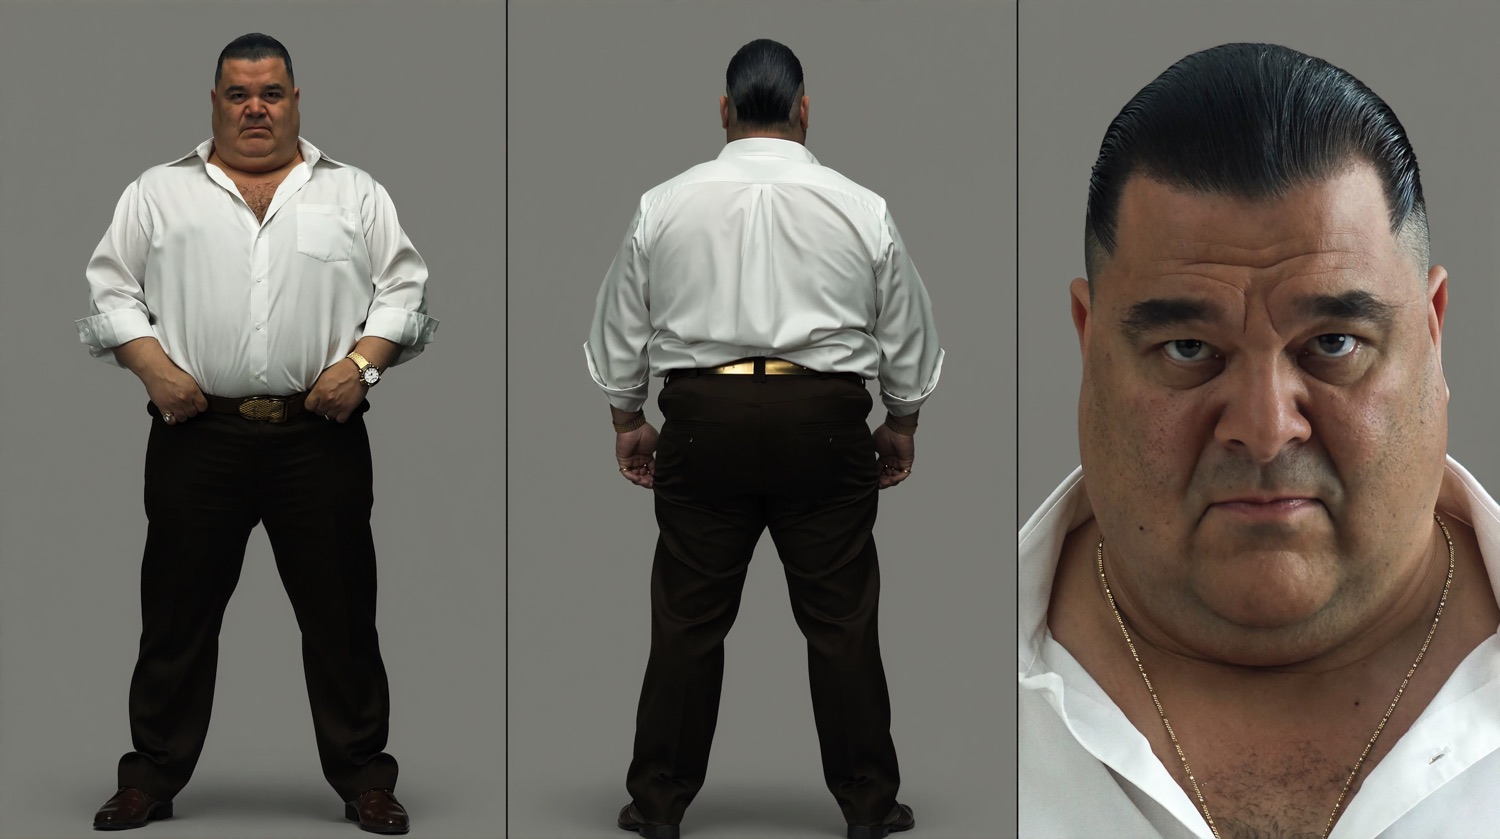
一张三联角色设定板,画的是一个胖猫式的黑帮老板,纯色无缝中性灰背景、均匀中性照明。
左格:全身,站在画面中央,双手自然垂下,正面偏 3/4;
中格:坐姿中景,坐在桌后,双臂搭在扶手上,略微前倾;
右格:头肩近景,与眼齐平,表情放松但眼睛在算账。
三格必须是同一个人、同一套服装、同一盏灯;不要文字、不要水印、不要道具。3.5 最关键的一步:把定妆图变成"视频元素"
这是整套方法里最值得学的一招。作者没有停在图片上,而是:用定妆图 + 自己录的一段声音,生成一条约 10 秒的表演视频,再把它存成可复用的元素。
// 视频元素 · 通用模板(Adam 版意译)
把附带的、已通过的角色图动画化成一段短视频参考。
严格保留他的脸、白发、眼睛、体型、黑色皮衣和银色配饰。
给他一个清晰的、可以看清嘴型的短句表演:他直视镜头略偏 3/4,
吸气,说出一句短台词,说完之后眼神不散、下颌微微收紧。
镜头固定不动,不要变焦、不要推拉;背景保持中性、干净、不变。
时长约 10 秒(工具默认片段长度)。不要出现第二个人,不要字幕。04造景:把空间也变成资产
角色的敌人是"换脸",场景的敌人是"换房间"。解法一样:先造一个空房间,之后所有镜头都回到这个房间。
"从干净、空的环境板开始。参考图负责布局、家具、材质和光;镜头和动作,由提示词负责。"
4.1 空景板的三条铁律
- 画面里没有人。一旦有人,模型就会开始编故事,布局反而跑偏。
- 机位必须写死。高度(贴地/膝/胸/眼)、角度(3/4 斜角)、朝向(看进纵深)—— 三者缺一,下一个镜头就接不上。
- 光要能复述。不是"氛围昏暗",而是"柱基有一排暖色上照灯、冷蓝灰雾、湿地面拉出长条暖反光"。
4.2 巷子 · @loc_alley_v1
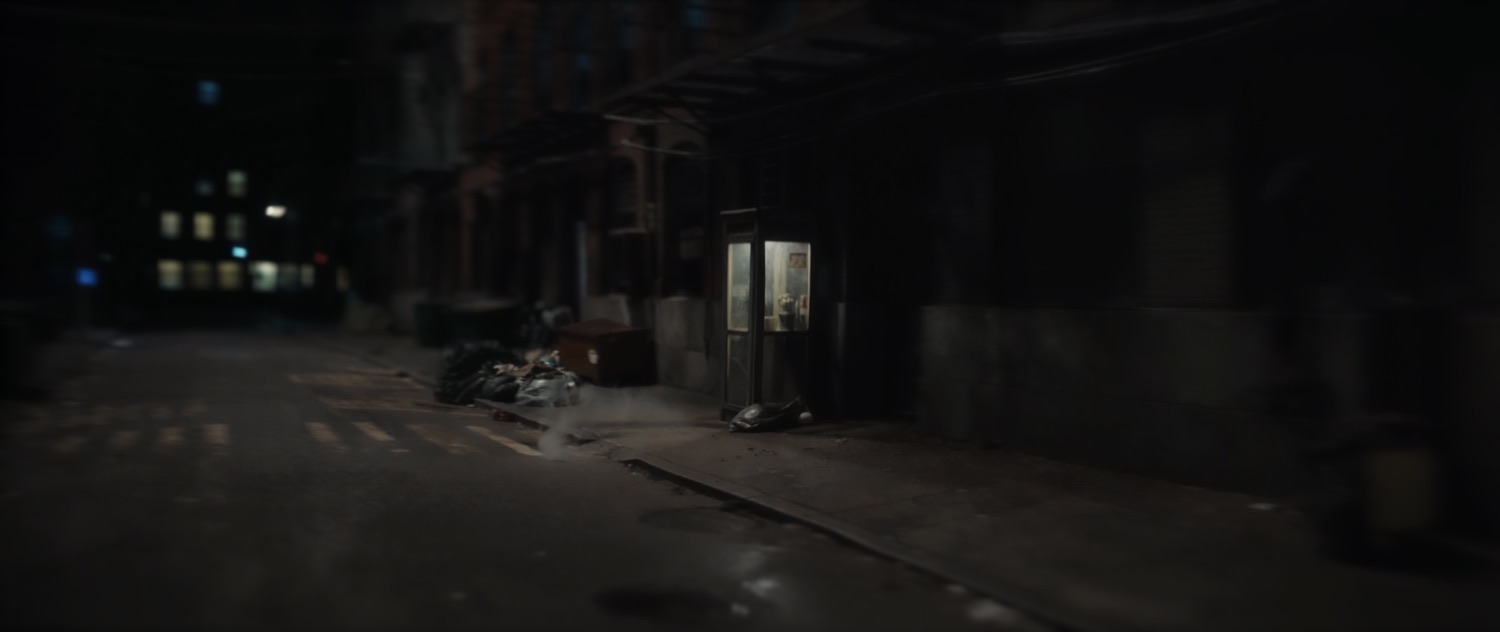
夜景后街的广角定场板,深黑新黑色电影调:
一条宽到足以开进汽车的巷子,两车道宽的湿沥青路面,
砖墙、远处一盏微弱的钠灯、靠左墙有一座老式玻璃与钢结构的电话亭。
3/4 斜角,摄影机在胸口高度、靠右侧墙、朝巷子深处看。
画面里没有人。焦点锁在电话亭的金属边框上,前景的砖墙化开,
远处的钠灯化成一团柔光。真实 35mm 胶片颗粒,2.39:1。4.3 Ron 的办公室 · @loc_room_ron_v1
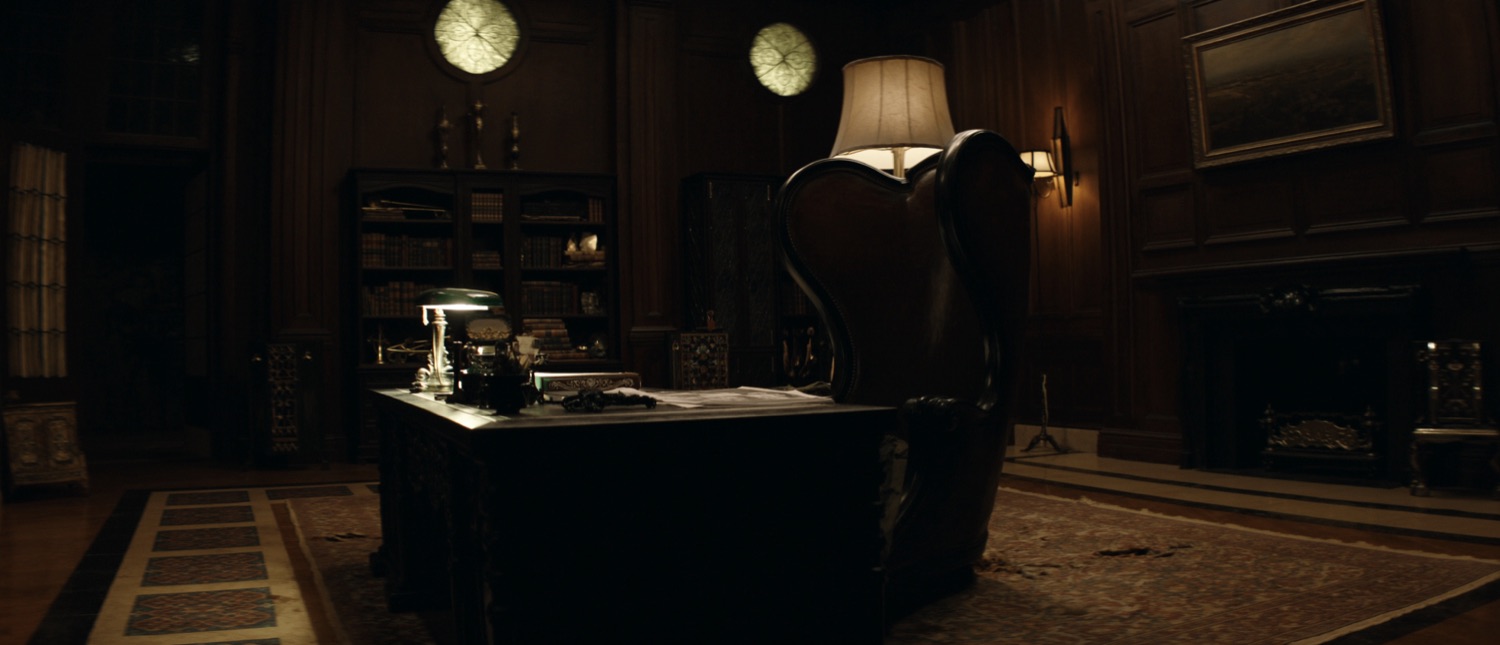
一个场景,两场戏
这间屋子在片子里出现两次:开场 Ron 打电话、结尾 Adam 交活。作者只做了一张板,两次都用它。这就是资产复用的收益 —— 观众会下意识觉得"这是同一个地方",哪怕中间隔了十分钟。
写法上要写清"桌子横贯画面、Ron 坐在近侧长边、身体朝画面右 3/4、台灯在左"—— 这些不是美术描述,是调度信息。
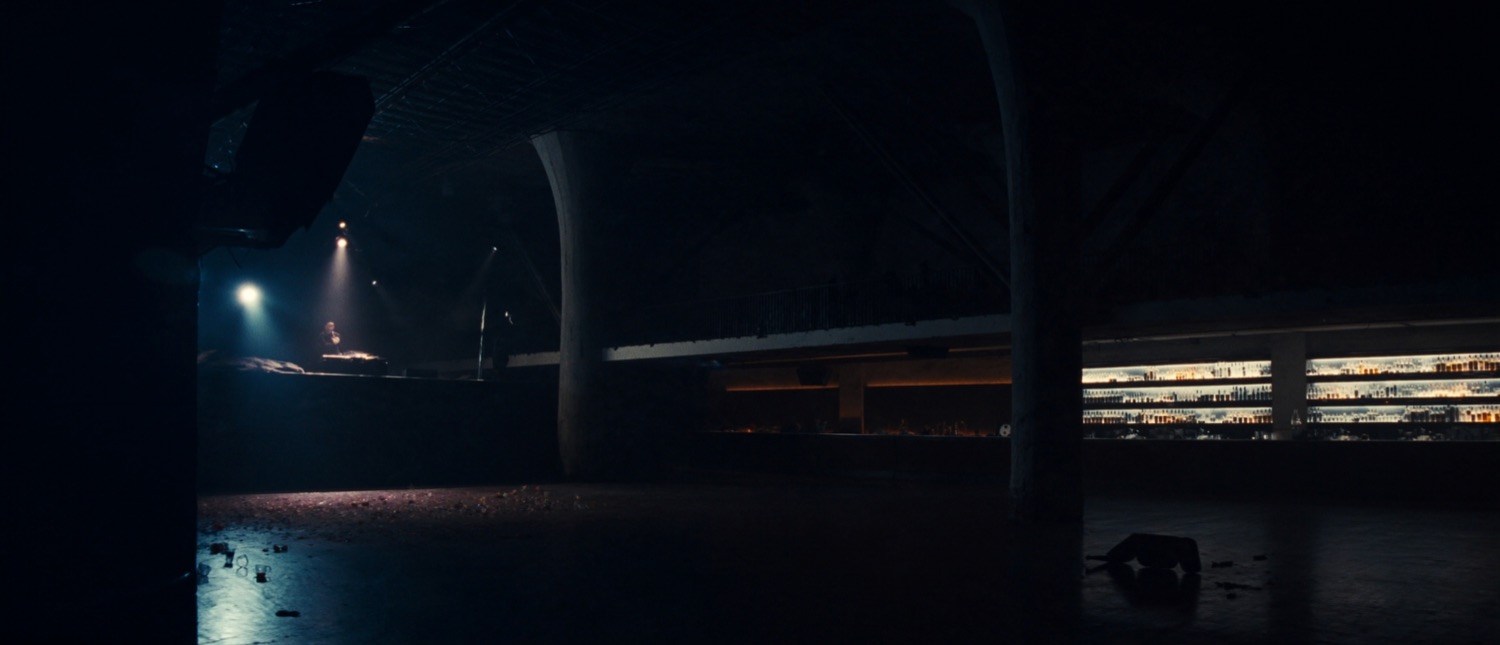
4.4 夜店舞池 · @loc_club_dancefloor_v1
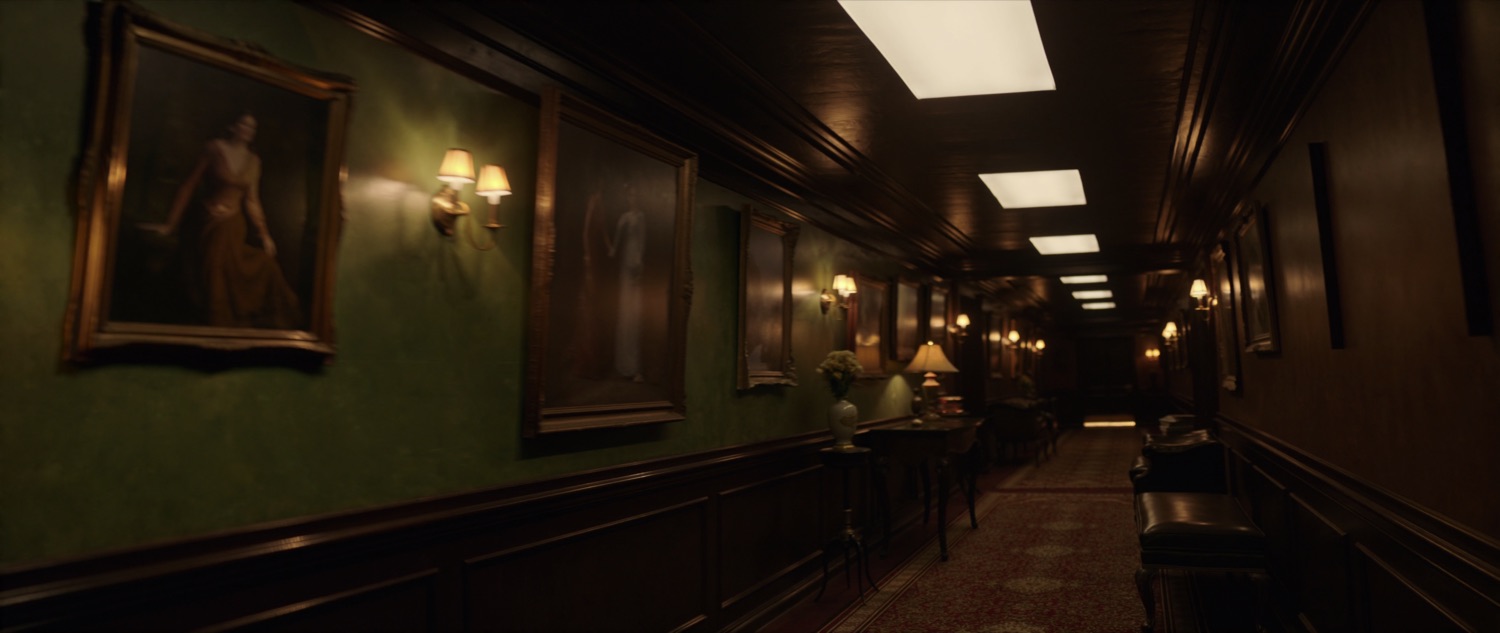
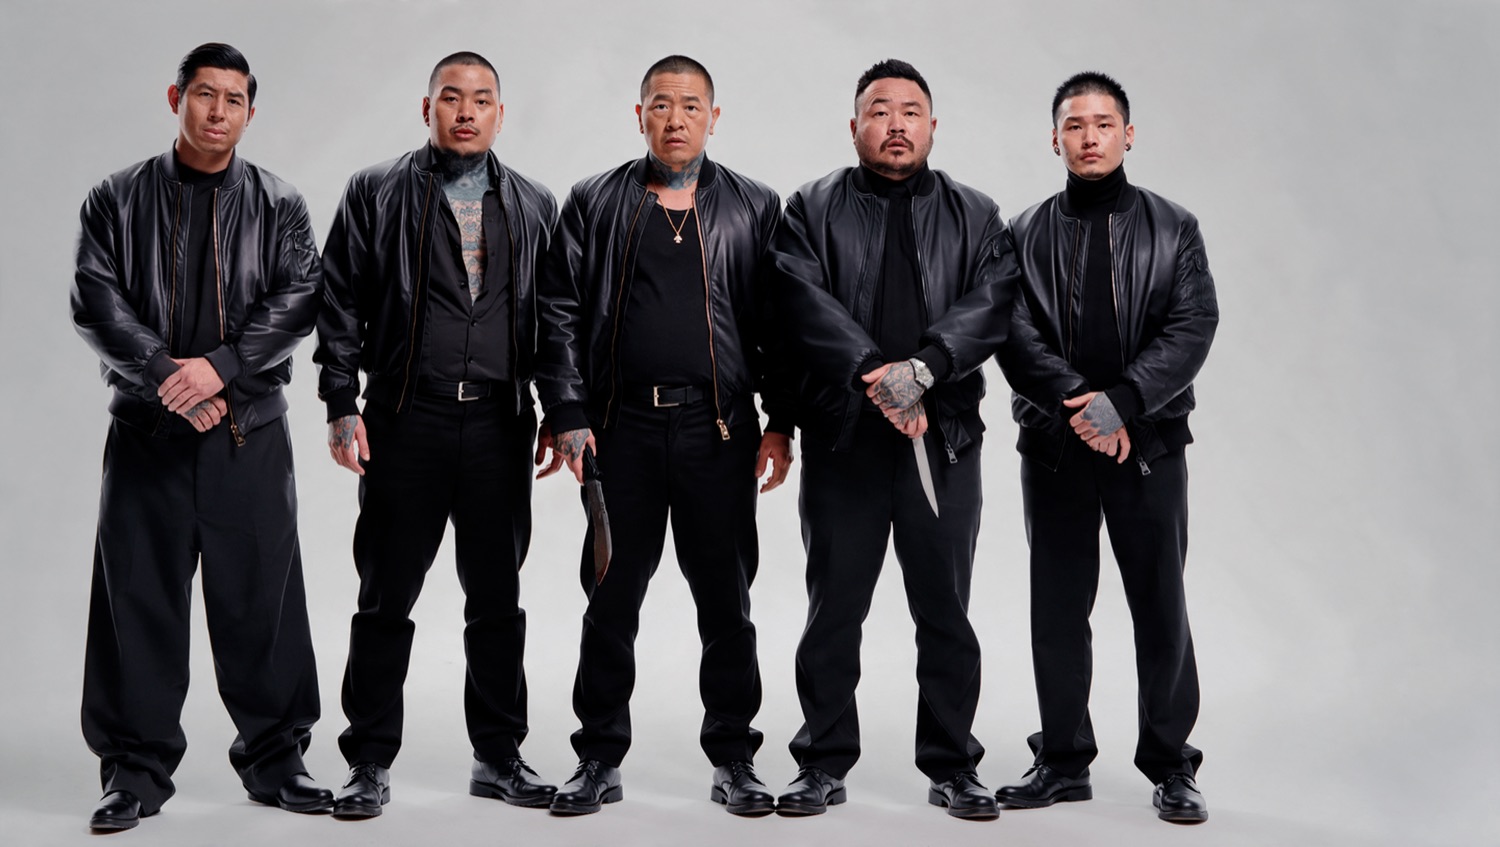
4.5 走廊与五个保镖
4.6 同一个房间的"另一面":反打
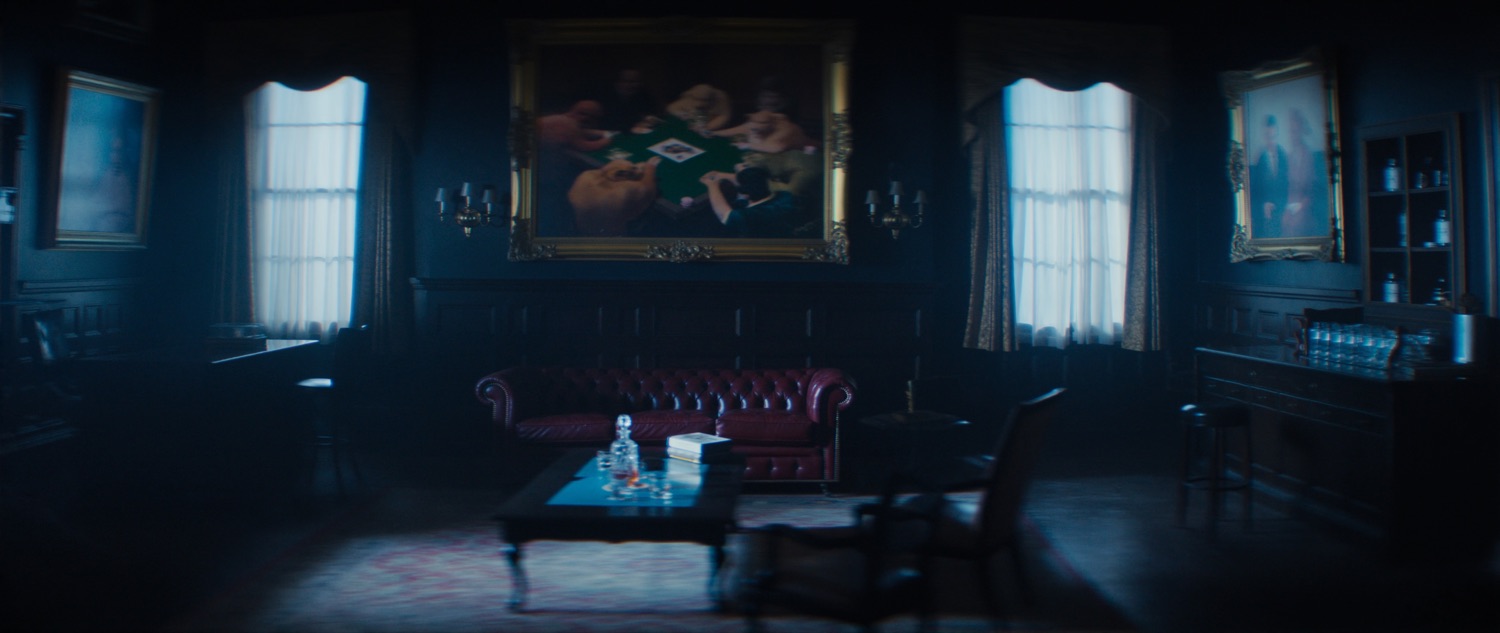
对话戏最难的是:你要拍桌子这头的人,也要拍桌子那头的人,而两者必须是同一个房间。作者的做法是做一张反打板(reverse angle)—— 从房间另一头看向门口,几何、材质、暖光全部对齐。
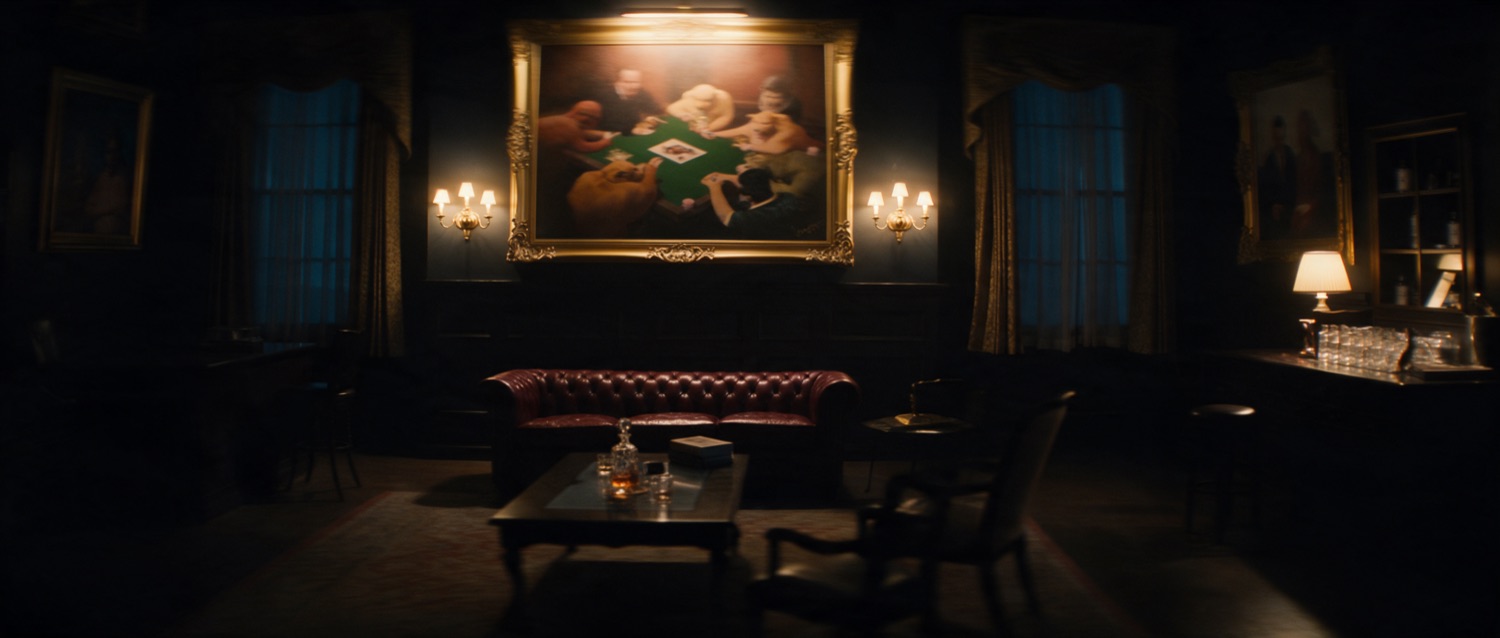
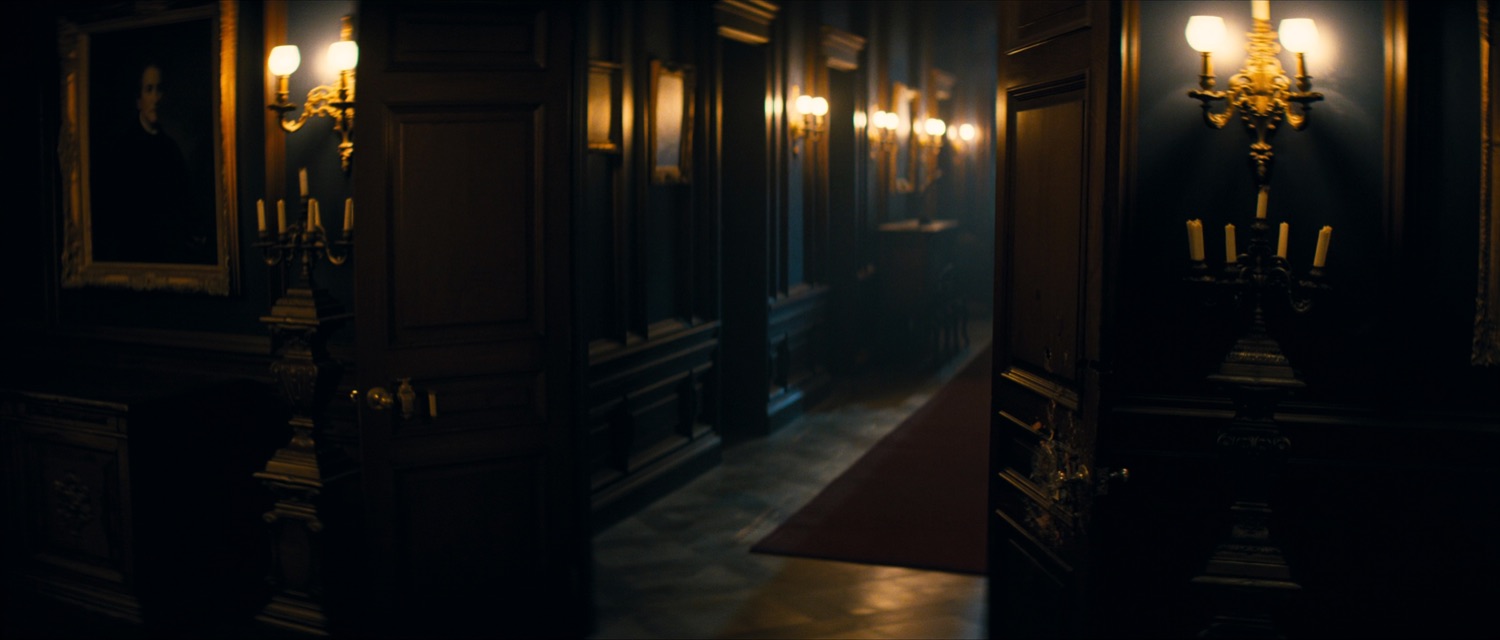
// 重打光提示词的写法:第一句就把边界钉死
只重打光。保持这一帧的一切不变:同一机位、同一 2.39:1 构图、同一镜头、
同一套家具、油画、窗帘、墙面、地毯、酒瓶和烟灰缸的位置都不动。
只把光源换成:右侧壁灯为主光,色温 2700K,桌面上留下一道明确的暖色光斑,
左侧墙面落入阴影,暗部保留细节、不要死黑。4.7 走位图:给打斗画一张平面图
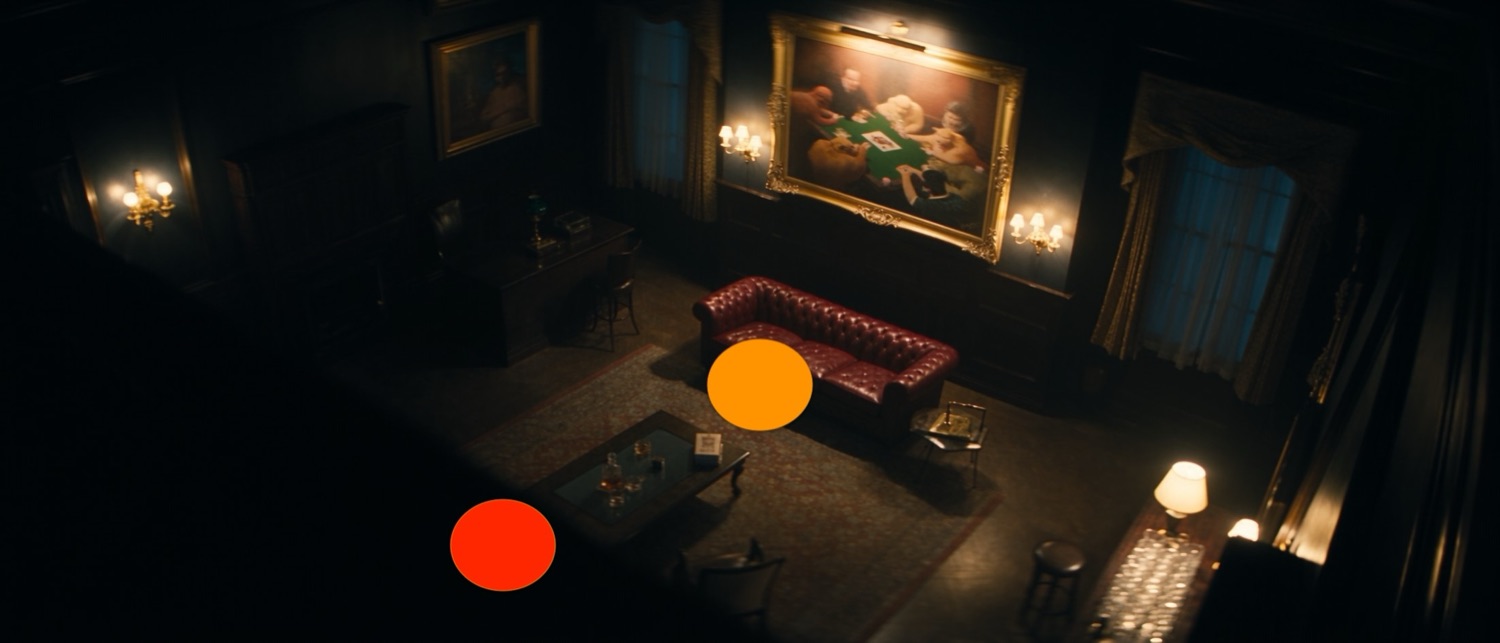
附件是 @image_1 的俯视走位图。
它是空间调度的唯一依据:Adam 从图的左下进入,Victor 在红色沙发的右前方站立,
两人相距约 2.5 米。这张图不是摄影机参考 ——
摄影机的位置、高度、焦段由下面的 CAMERA 段落决定,不按这张图的视角来拍。4.8 道具元素
道具同样是元素:@prop_bike(带尾箱的摩托)、@prop_adam_pistol(Adam 的手枪)、@prop_electric_baton(电棍)、@prop_spent_bullet(打穿的弹头)。
其中弹头是单独用 Seedream 5.0 Pro 做的一张"微距产品图":一颗从 Desert Eagle 射出的、已变形、空的 .45 弹头,放在纯色无缝中性灰上。理由很实在 —— 后面有一个镜头是弹头从他额头掉出来,形状和材质必须前后一致。
05骨架:一条提示词的 15 段
把 36 条提示词的段落名统计一遍,会看到同一套骨架反复出现。这就是这套工作流的"语法"。学会它,你写一条 30 秒的镜头段,只需要填空。
| # | 段落名 | 它到底在解决哪个不确定性 |
|---|---|---|
| 1 | SCENE CONTEXT 场景契约 | 这是第几块、总共几块、多长、什么画幅、此刻剧情到哪了、这场戏要结束在什么状态 |
| 2 | ACTIVE REFERENCES 引用清单 | 这一条用到哪些元素,每个元素分别负责哪一部分(脸/布局/光/道具) |
| 3 | IDENTITY LOCK 身份锁 | 多人同框时,谁是谁,不能混脸、不能串衣服 |
| 4 | LIGHT LOCK — ABSOLUTE 光锁 | 整场戏的光源位置/色温/对比,禁止任何镜头自由打光 |
| 5 | LOCATION MAP 空间地图 | 房间朝向、谁坐哪、门在哪、摄影机在哪一侧、人物往哪边走 |
| 6 | FIRST FRAME AND SPATIAL BLOCKING 首帧 | 第一个画面到底长什么样,人物在画面里的准确位置 |
| 7 | FORMAT MODE 形式 | 多镜头硬切?一镜到底?固定机位?手持? |
| 8 | OPTICS 光学 | 每一镜的视场角、机位距离、焦段在镜内锁死 |
| 9 | CAMERA 运镜 | 用三脚架还是手持,推/拉/摇/升,什么时候停 |
| 10 | ACTION TIMING 时间轴 | 把 30 秒切成 0–5s / 5–9s…,每段写清首帧、动作、台词、切点 |
| 11 | PHYSICS 物理 | 重量、接触、惯性、布料、水、人群的挤压 —— 让画面"有质量" |
| 12 | LIGHTING 具体光源 | 光锁之下,这一镜的可实用光源怎么落在人身上 |
| 13 | AUDIO 声音 | 只有现场声/音效;有没有台词;谁不出声 |
| 14 | STYLE + QUALITY | 质感基调 + 验收清单(这条最容易漏,也最有用) |
| 15 | POSITIVE CONSTRAINTS | 用"只允许发生什么"代替"不要发生什么" |
5.1 SCENE CONTEXT:先给模型一个"契约"
原文第一条写的是 Block 1 of 6. Thirty seconds, 21:9. —— 六个字就干掉了三件事:这是六块里的第一块(意味着后面还有,别自己收尾)、时长 30 秒、画幅 21:9。
场景契约
第 1 块,共 6 块。三十秒,21:9。
一通已经在进行的电话,横跨两个空间:Ron 已经折了一个自己人,
现在派 Adam 去杀那个动手的人。
这场戏的整体基调:压抑、旧派的暴怒 vs. 年轻的冷静。
它结束在:Ron 在电话那头被打断,Adam 挂机、跨上摩托离开。5.2 ACTIVE REFERENCES:每个元素只准负责一件事
原文这一节是逐行写的,一行一个 @,并且紧跟一句"它负责什么"。这个写法几乎是防跑偏的核心。
生效引用
@char_ron_video_v1 —— 视频元素 —— RON。脸、灰发、手、服装与参考一致。
嗓音:使用这条参考里的声音 —— 同样的音色,低沉、沙哑、气息重。
@char_adam_video_v1 —— 视频元素 —— ADAM。体型、皮衣、领口细银链、手与参考一致。
本场他只以背影剪影出现,不要给正脸。
@loc_room_ron_v1 —— 地点 —— RON 的办公室。控制布局、材质与实用光源:
厚重的木桌、一盏暖色台灯、玻璃烟灰缸、一部黑色座机。
@loc_alley_v1 —— 地点 —— 巷子。控制布局与材质:湿沥青、砖墙、
远处一盏微弱钠灯、靠墙一座老式玻璃钢电话亭。
@prop_bike —— 道具 —— ADAM 的摩托(带尾箱)。控制车辆外观。@名字 — 类型 — 它负责什么。特别是"本场他只以背影出现"这种出场限制,比任何"保持一致性"的空话都管用。
5.3 IDENTITY LOCK:三个男人不能长成一张脸
多人同框是 AI 视频最容易崩的地方。原文有一节的标题直接叫 IDENTITY LOCK — THREE DIFFERENT MEN,逐人固定年龄、体型、发型、服装、以及"他们的相对身高差"。
身份锁 —— 三个不同的男人
ADAM:二十多岁中期,180cm,白化病,纯白短发,苍白皮肤,黑色长皮风衣。
VICTOR:四十多岁中期,188cm,灰色短发与胡须,琥珀色眼睛,丝质西装。
RON:六十多岁,175cm,灰白短发,圆胖体型,深色开衫。
三个人的脸在任何镜头里都不能互相污染;
同框时保持上述身高差(Victor 最高、Adam 居中、Ron 最矮)。
任何一帧里,每个人的发型轮廓与服装都必须能被单独认出来。5.4 LIGHT LOCK — ABSOLUTE:光一旦锁死,房间就成立了
这是"电影感"和"AI 感"的分水岭。作者在夜店戏里连频闪的频率都写死了:
光锁 —— 绝对
每一个镜头的光,都是参考图里那一套光,不得新增光源、不得换色温:
柱基的一排暖色上照灯、冷蓝灰的雾、湿地面上的长条暖反光。
频闪每 3 秒一次,每次只亮一帧;火焰炮每 5 秒一次,在远处墙边、很小。
任何镜头都不得出现参考图以外的光源,
不得整体提亮、不得改变对比曲线。5.5 LOCATION MAP:用文字画机位图
空间地图
房间:桌子横贯画面左右。Ron 坐在近侧长边,身体朝画面右 3/4。
台灯在左,烟灰缸与座机在他手边。门在他身后的画面右后方。
巷子:一条从摄影机向远处钠灯收窄的通道。电话亭靠左墙、在近处纵深,
它的门朝着巷子内侧。摩托停在同侧墙边、在电话亭之外约 3 米处,车头朝巷子深处。
摄影机始终在 Adam 的右后方工作。注意它写的不是"一个老旧的房间",而是能被人走过去的方向。这就是"屏幕方向"(screen direction):观众靠它判断"他往哪走、她朝谁看",一旦反了,剪辑就会乱。
5.6 FIRST FRAME:第一个画面,精确到百分比
原文在夜店戏里把首帧写成了坐标表:门口在画面上方中央 (x 35%, y 10%),保镖在门内右侧 (x 53%, y 15%),左侧立柱从底到顶 (x 10–18%)…… 看着夸张,但它换来的是下一个镜头能对上。
首帧
开场在 Ron 的办公室。极近特写:Ron 的嘴、下颌和听筒,
从他右侧 3/4 看过去,摄影机滚转 15°,让台灯的光斜切过画面。
他的另一只手(夹着烟)只在画面边缘短暂入画。
同时,Adam 已经在巷子的电话亭里,面朝壁挂话机盒,
听筒贴在右耳、左手夹烟,肩膀填满画面。5.7 FORMAT MODE:先声明这是"哪一种拍法"
Controlled multi-shot sequence, 30 seconds, hard cuts.—— 受控多镜头,30 秒,硬切。ONE CONTINUOUS HANDHELD TAKE, shot from the hands of a man who cannot hold a camera still—— 一镜到底的手持,而且是"一个端不稳相机的人"拍的。这一句直接决定了整条片子的呼吸。one continuous take across two locations—— 一个镜头跨两个空间(用来做转场)。
5.8 OPTICS:用"度"而不是"毫米"
光学
特写:对角视场 47°,自然透视。
桌面中景:63°。
最后的巷子全景:84°,经典广角直线透视。
每个镜头内部,焦段锁死不动。实用光源周围允许轻微的水平光晕。理由来自那份 Anamorphic skill:视频模型不理解"50mm",它理解"视角有多宽"。所以整套流程统一用视场角,并且配一张换算表(见第 10 节)。
5.9 ACTION TIMING:把 30 秒切成可执行的块
这是整条提示词的"拍摄现场"。格式极固定:
动作时间轴
0–5s — 镜头 1 — @loc_room_ron_v1。
从 Ron 嘴下方一点拍的极近特写,右侧 3/4。摄影机滚转 15°,
让台灯的光斜切过画面。他对着听筒说:
RON:「这只该死的小狗,得学会自己的位置。」
他夹烟的手短暂入画边缘。硬切。
5–9s — 镜头 2 — @loc_alley_v1。
从 Adam 背后拍的紧特写。摄影机放在湿地面之上约 0.3 米,
刚好在电话亭敞开的门口内侧、略偏他右边。
他的深色肩膀、皮衣领口、贴在右耳上的听筒填满画面。
缓慢推近他的肩膀。烟一直在左手低处,一缕烟绕过肩头。
他的脸始终不露。听筒里,Ron 的声音更低、几乎像自言自语……
9–12s — 镜头 3 — …(依此类推)② 每段都必须写切点长什么样("硬切"、"切在金属磕碰声上"、"切在黑场");
③ 时间加起来必须正好等于 SCENE CONTEXT 里的总时长 —— 否则模型会自己拉伸或压缩。
5.10 PHYSICS:让画面有重量
AI 视频最典型的"假"是没有质量:人走路像滑行,人群像贴纸,衣服像塑料。原文的 PHYSICS 段落专门用来治这个。
物理
一个站在湿混凝土上的男人,重心压在一条腿上,然后用不均匀的步频
穿过拥挤的舞池,不碰到任何人:肩膀侧转去挤开人群让出的缝,
每一步都踩在节拍上;长外套在快步时甩开、在慢步时落定;链腰带摆动,皮革发出轻响。
舞动的人体有重量:脚离地、落地时膝盖弯曲,
落地的冲量喂给下一次弹起;手臂举过头顶会把肩膀拉起来再落下;
酒水在每次弹起时晃出、喷溅;松动的衣服和头发抬起又落下;汗水反光;
拥挤的身体互相撞上又弹开,整个人群像潮水一样涨落。5.11 AUDIO:只写"现场能听见的"
声音
只有音效,全部是画内声 —— 身体、脚步、玻璃、火焰、频闪;
DJ 只被看见、不被听见;没有任何台词。
满场爆发的轰鸣、几百只脚落在湿混凝土上、喊叫、口哨、笑声、拍手;
他的靴子先独自踩在湿地上,然后被淹没在人群里;
皮衣在他转身时发出摩擦声;链腰带敲在皮革上。
火焰炮每 5 秒一次的轰声,频闪每 3 秒一次的干涩咔哒。
不要旁白,不要字幕。5.12 QUALITY:把"验收清单"写进提示词
这是我个人认为最值得抄的一节。它不写"高质量、超写实",而是写一张检查表,逐条列出这一镜必须同时成立的事实。
质量(验收清单)
首帧在角度、高度、布局和光上与参考帧一致 —— 门在上方中央、
左前景的立柱与上照灯、男人独自站在左中位置的空地、人群占满右半边;
四个镜头、硬切;Adam 的每个镜头都是 3/4 角,脸在该实的地方实,
眼睛与参考一致;他的走路不均匀、会绕;头左右转动;
人群在每一个镜头里都
—— 每个人都是不同的人、不同颜色、有自己的动作,
没有克隆脸、没有融合的身体、没有重复的四肢;
—— 没有任何人被碰到,没有围成一圈,除了门口那个门童,没有人站着看;
—— 十次频闪都只有单帧,且都不落在镜头的第一帧上;
运动穿过每一次闪光连续不断,绝不出现定格或重复帧;
—— 没有人看向镜头;每个镜头的光与参考图完全一致,
没有新增光源、没有偏色;火焰炮在墙边、远而小。
硬切,不要叠化。"不要有克隆脸" vs "每个人都是不同的人、有自己的动作,没有克隆脸"。后者同时给了要做的和不要的,模型有了正向目标,失败率显著下降。
5.13 POSITIVE CONSTRAINTS:用"只允许"代替"不要"
正向约束
一镜到底,一个骑手,脸始终不露 —— 近景段摄影机低于下巴,其余段在他身后。
整条都是深夜:从天际线到画幅顶端都是黑天,地平线与天顶是同一种黑,
画面里每一个光源都是路灯、车灯、窗灯或航空障碍灯。
右侧通行:Adam 在右车道,迎面车灯在左车道。
路面全程干燥。摄影机先从车轮与大衣的低位前 3/4 开始,
绕到他身后,然后一个动作里拉远并升起,变成整座桥的广角,
桥塔与黑色城市在黑色天空之下,屋顶上浮着薄薄的烟霾。5.14 三块"可选扩展":台词、表演、群演
| 块 | 什么时候加 | 作用 |
|---|---|---|
DIALOGUE — VERBATIM AND COMPLETE | 有台词的戏 | 逐字锁定台词,并规定"硬切只切画面,一句话不能被切断" |
ACTING TASK — 角色名 | 需要表演时 | 给眼睛一个任务:动机/目标/障碍/战术/逐句动作 |
THE CROWD / NO CONTACT — LOCKED | 群戏 | 规定人群密度、每个人独立动作、主角与人群零接触 |
5.15 一条可以直接填空的模板
// 30 秒镜头段 · 通用模板(把尖括号换掉即可)
场景契约
第 <N> 块,共 <M> 块。<三十>秒,<21:9>。<一句话说清此刻剧情与情绪>。
本块结束在:<结束状态>。
生效引用
@<角色视频元素> —— 视频元素 —— <名字>:脸/发型/服装/嗓音以参考为准。<出场限制>
@<地点元素> —— 地点 —— 控制布局、材质与实用光源:<三到五个具体物件>。
@<道具元素> —— 道具 —— 控制外观。
身份锁 <多人同框时逐人固定年龄/身高/发型/服装>
光锁 —— 绝对 <光源清单 + 色温 + 禁止新增光源>
空间地图 <房间朝向 / 谁在哪 / 门在哪 / 摄影机在哪一侧>
首帧 <极近/近/中/广 + 角度 + 关键物件的画面位置>
形式 <多镜头硬切 / 一镜到底手持 / 固定机位>
光学 <每镜:对角视场角 + 机位距离 + 镜内焦段锁死>
运镜 <三脚架/手持;推/拉/摇/升;什么时候停>
动作时间轴
0–<t1>s — 镜头 1 — <地点>。<首帧描述>。<动作>。<台词>。<切点>。
<t1>–<t2>s — 镜头 2 — …
物理 <重量 / 接触 / 惯性 / 布料 / 水 / 人群>
声音 <画内音效清单;有无台词;不要旁白/字幕>
质感 <写实 / 胶片颗粒 / 对比 / 色彩>
质量(验收清单) <逐条写出必须成立的事实>
正向约束 <只允许发生什么>06数据:36 条提示词解剖
我把原文里 36 条提示词全部抓下来量了一遍。数字本身就在讲方法论。
36
条提示词
覆盖全片 5 场 17 个镜头段
665,455
字符总量
约等于一本中篇小说
11,814
中位数字符数
最短 505 / 最长 57,323
| 类型 | 条数 | 长度特征 | 它们在解决什么 |
|---|---|---|---|
| 人物/道具资产 | 7 条 | 505 – 6,165 | 一次说清"这个人长什么样",之后永不再改 |
| 地点空景板 | 7 条 | 2,520 – 8,254 | 布局、材质、光源 —— 给后续所有镜头一个可回去的地方 |
| 镜头段(剧情) | 17 条 | 8,914 – 57,323 | 30 秒内的分镜、时间码、表演、物理、声音 |
| 特殊工序 | 5 条 | 3,291 – 16,269 | 重打光、反打、换覆盖、续拍 |
6.1 全部 36 条,按原文顺序
| # | 段落 | 字符数 | 它真正在解决的事 |
|---|---|---|---|
| 1 | Adam 卷发设计 · GPT Image 2.5 | 6,012 | 从一张真人照片重建角色,保住五官、换掉发色肤色体型 |
| 2 | Adam 直发设计 · GPT Image 2.5 | 6,165 | 同上,只改发型 —— 控制变量对比 |
| 3 | 纹理精修 · Seedream 5.0 Pro | 505 | 去 AI 味:四张单职责纹理参考,只修右格 |
| 4 | Ron 角色板 | 4,845 | 三联画:体型 / 坐姿 / 近景一次给全 |
| 5 | Adam 视频元素模板 | 567 | 定妆图 + 嗓音 →约 10 秒"活人参考" |
| 6 | Victor 视频元素模板 | 545 | 同上,锁住反派的脸与音色 |
| 7 | Ron 视频元素模板 | 564 | 同上 |
| 8 | 巷子 · @loc_alley_v1 | 2,520 | 空景板:3/4 角、湿沥青、钠灯、电话亭 |
| 9 | Ron 办公室 · @loc_room_ron_v1 | 2,796 | 同一场景要服务开场与结尾两场戏 |
| 10 | 夜店舞池 · @loc_club_dancefloor_v1 | 3,157 | 空场先立,人群后加 |
| 11 | Scene 1.1 电话 | 13,576 | 两个空间一通电话,四个可用 take |
| 12 | Scene 1.2 桥上夜行 | 8,914 | 20 秒一镜到底:跟随 → 绕到身后 → 拉开升起 |
| 13 | Scene 1.3 抵达夜店 | 24,162 | 一镜跨两个空间:街面 → 走廊 |
| 14 | Scene 2.1 进入人群 | 22,659 | 首帧坐标表,让人与环境严丝合缝 |
| 15 | Scene 2.2 派对 B-roll | 23,149 | 12 个镜头,起重臂从靴子开场 |
| 16 | Scene 2.3 搜寻舞池 | 18,299 | 3/4 角一路看脸,人群不停 |
| 17 | Scene 2.4 回头 | 18,639 | 一个"怀疑"的节拍,靠头转完成 |
| 18 | Scene 2.5 保镖发现 | 19,396 | 9 个镜头,从 DJ 的手开场,把派对变成威胁 |
| 19 | Scene 2.6 夜店打斗 | 40,305 | 21 个镜头的一打三,打斗蒙太奇 |
| 20 | Scene 3 走廊参考 | 8,254 | 狭窄画廊的布局与光的底座 |
| 21 | 走廊群像 · Soul Cinema | 2,949 | 五个可分辨的保镖,一字排开 |
| 22 | Scene 3.1 保镖闲聊 | 42,464 | 30 秒一镜手持,靠对话立人物 |
| 23 | Scene 3.2 走廊打斗 | 42,272 | 一镜手持;两个 take 拼接,接缝藏在甩镜里 |
| 24 | Scene 3.3 大衣与枪 | 40,304 | 打完之后的"静":理大衣、跨过人、拔枪 |
| 25 | Scene 4 办公室参考 | 5,729 | 沙发的墙与房间几何 |
| 26 | 重打光 · Seedream 5.0 Pro | 3,291 | 只改光,不改几何 |
| 27 | 反打 · Soul Cinema | 6,911 | 同一房间的另一面 |
| 28 | Scene 4A 对话 | 51,314 | 五句台词逐字锁死;六个 take 拼一场 |
| 29 | 弹头参考 · Seedream 5.0 Pro | 3,911 | 微距产品图,为后面的"弹头掉出"定形状 |
| 30 | Scene 4B.1 弹头穿出 | 54,454 | 弹头必须完整离开额头且不变形 |
| 31 | Scene 4B.2 变形 | 57,323 | 用 Adam 的后背遮住变身过程 |
| 32 | Scene 4C 探索房间 | 12,001 | 广角/中景/俯视三套空镜,给打斗铺底 |
| 33 | Scene 4C.1 基础打斗 | 51,689 | 15 镜 / 14 个硬切,每 2 秒一刀 |
| 34 | Scene 4D 换覆盖 | 16,269 | 把已有打斗当 @video_1 重拍一遍机位 |
| 35 | Scene 4E 收招 | 11,626 | Forward Extend 续 10 秒,收在脸上 |
| 36 | Scene 5 回到办公室 | 37,919 | 四句台词,切黑在转身中途 |
6.2 三个反直觉的读数
① 资产短、镜头长 —— 但"约束密度"正好相反
角色板 6,000 字符里,绝大多数是描述(他长什么样)。镜头段 50,000 字符里,绝大多数是禁止与规定(不许换光、不许换脸、不许切台词)。前者是"给模型一个目标",后者是"给模型一个笼子"。新手常把力气用反:花两小时描述画面,却不写一句"不许变"。
② 最长的三条,都不是"画面最复杂"的
最长的是 4B.2 变形(57,323)、4B.1 弹头穿出(54,454)、4C.1 基础打斗(51,689)。它们共同点是:有物理连续性难题——弹头要怎么掉、变身要怎么被遮住、15 个镜头的每一拳落在哪个部位。提示词的长度,应该跟"失败一次的代价"成正比。
③ 标题不是给人看的,是给模型定位的
36 条里,ACTIVE REFERENCES / PHYSICS / AUDIO / STYLE 各出现 17 次,POSITIVE CONSTRAINTS 13 次。这些全大写的段落名相当于锚点:模型在长文本里靠它们判断"现在读的是哪一类信息",你改一段也不会污染其他段。
07逐场拆解:5 场 17 段
下面按片子顺序走一遍。每一段只讲三件事:这场戏要什么、用了什么手法、你能抄走什么。
注:本页内嵌 18 段成片视频(共约 36 MB),点开即播,无需联网。画面与提示词一一对应 —— 这正是「提示词写清楚了,模型就照做」的证据。
第一场 · 电话(Scene 1.1 – 1.3)
1.1 电话 · 30 秒 · 21:9 · "六块里的第一块"
- 要什么:Ron 暴怒、Adam 冷静;一句话没说完就被挂断;然后 Adam 骑车离开。
- 手法:两个空间来回硬切。Ron 那边用固定三脚架,让他的身体动作自己制造能量;Adam 那边只给背影,脸始终不露。
- 抄什么:"一条提示词 = 四个可用 take"。作者不是要一条 30 秒的成片,而是要从一条生成里摘出四段可用素材:开场、Ron 的表演、挂机、离开。剪辑时再拼。
1.2 桥上夜行 · 20 秒 · 一镜到底
- 要什么:把巷子接到夜店,同时给片名留位置。
- 手法:摄影机先在低位前 3/4 拍车轮与大衣,一个动作里绕到车后、再拉远升起,变成整座桥的广角。
- 抄什么:写"三个动作合成一个连续运动",而不是写"环绕镜头"。前者可执行,后者只能靠运气。
另外:天空必须纯黑——"从天际线到画幅顶端都是黑天,地平线与天顶是同一种黑"。这句是为了给片名留出可读的负空间。
1.3 抵达夜店 · 30 秒 · 一镜跨两个空间
- 要什么:从摩托车停车 → 门口 → 黑暗走廊 → 舞池冷光打到他脸上。
- 手法:用一个"醉汉"作为前景遮罩,把两个空间缝成一个镜头。
- 抄什么:跨场景转场别用叠化,用前景物体(人、车、柱子)扫过镜头,把接缝吃掉。
第二场 · 夜店(Scene 2.1 – 2.6)
2.1 进入人群 · 30 秒 · 4 镜
- 开场就是参考帧复现:门在上方中央、立柱在左前景、他独自站在左中空地。
- 首帧用 x/y 百分比把每个物件钉死。
- 抄:把参考图的构图当成"第一帧"来复述,后面才好接。
2.2 派对 B-roll · 30 秒 · 12 镜
- 一个起重臂镜头开场,特写他的靴子,再升起。
- 人群的"不知道即将发生什么",是用来反衬暴力的。
- 抄:B-roll 也要有叙事任务(反差),不能只是"热闹的画面"。
2.3 / 2.4 搜寻 / 回头 · 30 秒
- 全程 3/4 角,他从一张脸看到另一张脸,脚步不停。
- 2.4 只加了一个"回头"的节拍,就把怀疑立住了。
- 抄:一个动作 = 一个段落。别在一条提示词里塞两个情绪转折。
2.5 保镖发现 · 30 秒 · 9 镜
- 从 DJ 的手开场 —— 先给"正常",威胁才显得突然。
- 资深保镖一句 "Kill him",紧接着电棍特写。
- 抄:把"命令"和"凶器"剪在一起,比任何打斗都吓人。
2.6 夜店打斗 · 30 秒 · 21 镜 · 打斗蒙太奇
- 要什么:一打三,但观众必须看得懂"他先解决了身后那个,再解决右边,最后是左边的资深保镖"。
- 手法:把 21 个镜头写成一条可读的顺序,每镜只负责一个接触点;起重臂从 Adam 正上方开场,建立"他被围住"的空间感。
- 抄什么:群架不要写"混战"。写顺序:谁先、谁后、每个人最后什么状态。观众能读懂,是因为你写清楚了,不是因为 AI 拍清楚了。
第三场 · 走廊(Scene 3 – 3.3)
3.1 保镖闲聊 · 30 秒 · 一镜手持
- 要什么:用一场关于吸血鬼电影的闲聊建立人物,再把注意力转向 Adam。
- 手法:全程手持、剧烈抖动,"像一个拿不稳相机的人拍的"。台词是逐字锁死的,谁说什么、谁不出声都写明。
- 抄什么:把"手持"写成一个人格(端不稳相机的人),比写"handheld camera"有效十倍。
3.2 走廊打斗 · 30 秒 · 两个 take 拼一条
- 要什么:Adam 入场 → 一连串清晰的打击,每个保镖都要能被单独认出。
- 手法:拍两条(入场+开场打斗、打斗延续),在甩镜模糊与身体运动里接起来。
- 抄什么:AI 一次只能给你 30 秒,那就把 60 秒的戏拍成两条,再找运动最快的那一帧接。接缝要藏在"画面本来就糊"的地方。
3.3 大衣与枪 · 30 秒 · 一镜手持
- 要什么:打完之后的"静":他理好大衣、跨过倒下的人、拔枪。
- 手法:动作全部放慢,只留布料、靴子、呼吸的声音。
- 抄什么:暴力之后的整理动作,比暴力本身更能立人物。这条在写剧本时就要留出来。
第四场 · 书房(Scene 4 – 4E)
4A 对话 · 30 秒 · 五句台词 · 六个 take 拼成
- 要什么:一场"克制力的决斗":Adam 下达判决,Victor 的玩笑逐渐变成恼怒。
- 手法:①台词逐字锁死,标注"念到最后一个字才算完成";②硬切只切画面,不切台词 —— 一句话开始了就必须说完;③给每个角色写
MOTIVE / GOAL / OBSTACLE / TACTIC;④六个 take 各取一段,按时间戳拼。 - 抄什么:台词戏的稳定性,来自"不许被剪辑切断"这条明文规定。模型不知道你要保留整句,它就会为了节奏给你切掉半句。
4B.1 弹头穿出 · 30 秒
- 要什么:Victor 中枪后恢复;弹头必须完整离开额头并落下,且形状不变。
- 手法:先单独做一张弹头微距图当
@prop_spent_bullet;提示词里写死"形状与参考一致、掉落过程中不变形"。 - 抄什么:凡是"物件必须保持形状"的镜头,先给它一张独立道具图。别指望模型记住上一镜的弹头。
4B.2 变形 · 30 秒
- 要什么:Victor 变成狼人,但不能让观众看清"变形"的中间过程(AI 做不好中间帧)。
- 手法:用 Adam 的后背挡住变身,等镜头再打开时,已经是完成体。
- 抄什么:用遮挡代替特效。凡是 AI 做不好的连续过程,就用一个前景物体把它藏起来 —— 这既是技术方案,也是老派电影的做法。
4C.1 基础打斗 · 30 秒 · 15 镜 / 14 个硬切
- 要什么:打斗贴着红沙发进行,房间在任何一帧都不能变。
- 手法:先把走位图当
@image_1固定起始位置;然后 15 个镜头、在 2.0/4.0/6.0…秒处精确硬切;每个攻击都有"接近—接触—反应"三段。 - 抄什么:把剪辑点写进提示词。"每 2 秒一个硬切"这种话,模型真的会照做,而且比你在后期切更连贯。
4D / 4E 换覆盖 + 收招
- 4D:把已经拍好的打斗视频当
@video_1,只换机位重拍一遍(更广、更低、加前景遮挡),动作完全一致。 - 4E:用 Forward Extend 从最后一帧续 10 秒:他收招,摄影机推到他脸上,喘气。
- 抄什么:这两招是"用 AI 做后期"的核心:先拍一条能用的动作,再从它身上长出别的机位和结尾。这比重新生成便宜得多,也稳得多。
第五场 · 回到办公室(Scene 5)
30 秒 · 四句台词 · 切黑在转身中途
- 要什么:权力关系翻转。Adam 交活、说自己不干了、转身要走,直到 Ron 说"你父亲回来了"。
- 手法:袋子"小、闭合、用文字描述"(不给参考图,避免模型自由发挥);Adam 只在"back"这个词上停;惊喜转愤怒,然后在转身中途硬切到黑。
- 抄什么:片尾不要给"完整动作"。在动作中间切断,观众自己会补完 —— 而且这个镜头之后不需要任何素材。
08进阶:重打光、反打、补拍、续拍
前面是"第一次生成"。这一节是真正的分水岭:拿到一条能用的素材之后,怎么从它身上长出更多东西。
8.1 重打光:先拍几何,再换情绪
作者的顺序很讲究:先做一张冷光版(几何最准),再用它当输入做一张暖光版(情绪最准)。之后所有对话戏都用暖光版当参考,所有"看布局"的判断都用冷光版。
| 版本 | 用途 | 写法要点 |
|---|---|---|
| 冷光原版 | 几何基准 | 无人的空房间,机位、构图、家具位置全部固定 |
| 暖光重打光版 | 情绪基准 | 第一句:"只重打光。保持这一帧的一切不变。"然后才写光 |
// 重打光提示词的语序(这个顺序不能乱)
1. 只重打光。
2. 保持不变:同一机位、同一构图、同一镜头、同一套家具与陈设。
3. 改成什么:右侧壁灯为主光,2700K,桌面上留一道明确的暖色光斑,
左侧墙面落入阴影,暗部保留细节、不要死黑。
4. 不允许:改变任何物体的位置、比例、材质。8.2 反打:让"另一面墙"也成立
对话戏只要有一个反打,观众就会相信这是一个真实的房间。做法:
- 从房间另一头朝门口看,机位高度换成"站立眼平"(原机位是"坐姿眼平 110cm")。
- 必须交代那面墙上的东西:门、护墙板、地毯边缘、灯的位置。
- 暖光的方向要能对上 —— 正面机位里光来自右壁灯,反打里光就应该从画面左侧来。
8.3 Re-coverage:把已有动作当"素材"重拍一遍机位
4D 那一段是整篇文章里最"工业化"的一招。做法:
- 选一条打得好的基础打斗视频,作为
@video_1附上。 - 提示词第一句就写死:这是对参考视频的重新覆盖,同一个打斗、同样两个人、同样的位置与动作。
- 只改
CAMERA/OPTICS:更广、更低、加前景遮挡。 - 目的:让同一段动作在不同机位下出现,剪起来像"多机位拍摄"。
// Re-coverage 起手式(4D 段落意译)
ALLERGIC — VICTOR 的办公室 — 打斗,对参考视频的重新覆盖。30.0 秒。
@视频 29 · 30 秒 是源:同一场打斗、同样两个人、同样的起始位置、
同样的动作顺序与接触点。
唯一改变的是摄影机:这次用更广的视场、更低的机位、
并且在画面左前景加一根柱子作为遮挡。
动作本身不得改动:谁出拳、打在哪、对方怎么倒,全部与源一致。8.4 Forward Extend:从最后一帧往后长 10 秒
用在"动作差一点点就收完"的地方。原文 4E 的做法:选中片段 → Forward Extend → 描述接下来发生什么。
// 续拍提示词(4E 意译)
续拍 —— ALLERGIC — VICTOR 的办公室 — 打斗的结尾。10.0 秒,一个不间断的手持镜头,
直接从源视频的最后一帧继续:
Adam 把最后一下推到底,Victor 的身体落定;
Adam 松手、向后退半步、肩膀落下;
摄影机缓慢推近他的脸,他喘气,眼神从 Victor 身上移开,看向别处。
保持:同样的站位、同样的握持、同样的光、同样的服装与血迹分布。8.5 接缝:把两条片子缝成一条
| 手法 | 怎么用 | 适合什么 |
|---|---|---|
| 甩镜模糊 | 在镜头快速横摇、画面全糊的两三帧处切 | 打斗、奔跑、转身 |
| 身体遮挡 | 让一个人/一件大衣扫过镜头,用它的背面挡住切换 | 换机位、换角度 |
| 前景扫过 | 汽车、行人、柱子经过前景的一瞬间切 | 跨场景转场 |
| 切黑 | 动作进行到一半直接黑场 | 收尾、时间跳跃 |
| 声音桥 | 下一场的声音先到,画面后到 | 两个空间的连续(如电话戏) |
8.6 多 take 拼接:用时间戳做剪辑表
4A 那场对话戏由六个 take 里的不同片段拼成,提示词里直接标出"每个 take 保留哪一段"。这其实是在用提示词写剪辑表:
// 剪辑表式写法
对白戏由六个不同的 take拼接而成。下面标注每个 take 保留的片段:
take 1 —— 0.0–4.2s:Victor 递酒、微笑(保留)
take 2 —— 2.8–6.5s:Adam 抬眼,说「Kenny 死了」(保留 5.1–6.5s)
take 3 —— ……
台词的每一个字都必须被听到;
如果时间对不上,让台词赢。0925 条可以直接抄的技巧
把前面的内容压成卡片。每条都写成"什么时候用 + 怎么写"。
01 · 资产先行
先做元素,再拍镜头。所有角色/地点/道具先命名、先固化,之后只引用不描述。
02 · 双联画角色板
左全身(50mm、胸高)+ 右近景(85mm、眼平),同一块无缝灰底、同一盏硬光、同一套服装。
03 · 身份锁起手式
"把附图当严格身份参考:五官结构必须认得出是同一人;以下部分要改:__;以下部分不许变:__。"
04 · 一次只改一个变量
卷发/直发两版对照。任何"哪个更好"的判断,都必须在只差一个变量的前提下做。
05 · 单职责纹理参考
一张图只给一个材质:头发、皮肤、背景、布料分开给。500 字符就能去掉大半 AI 味。
06 · 视频元素
定妆图 + 真人录音 → 约 10 秒表演。同时锁住脸、嗓音、微表情。
07 · 空景板三铁律
画面里没有人;机位高度与角度写死;光要能被复述成清单。
08 · 3/4 斜角
机位在空间一侧、斜着看进纵深。这是让宽画幅"有层次"的最省力办法。
09 · 光锁
写死光源、色温、对比,加一句"不得新增光源、不得整体提亮"。跨镜头统一全靠它。
10 · 身份锁(多人)
逐人固定年龄/身高/发型/服装,并写出相对身高差,防止两张脸融合。
11 · 空间地图
用文字写"桌子横贯画面、他坐近侧、门在右后方、摄影机在右后方"。这是屏幕方向。
12 · 首帧坐标
关键物件给 x/y 百分比。下一个镜头要接得上,靠的就是这张"坐标表"。
13 · 用角度不用毫米
"对角视场 47°"比"50mm"有效。并加一句"每个镜头内焦段锁死"。
14 · 时间码切镜
0–5s / 5–9s…,每段以"镜头 N"开头,方便单独重生成。
15 · 把剪辑点写进提示词
"15 个镜头、14 个硬切、每 2 秒一刀"—— 模型真的会照做。
16 · 物理段
重量、落地弯膝、布料甩动、水花、人群互相挤压。"假"的根源是没有质量。
17 · 只写画内声
列出能被听见的具体声音;明确"没有台词/不要旁白/不要字幕"。
18 · 验收清单式 QUALITY
不写"高质量"。写"每个群众都是不同的人、有自己的动作、没有克隆脸"。
19 · 正向约束
用"每次踢腿都停在腰带以下"代替"不要高踢腿"。负面词会召唤它命名的东西。
20 · 手持写成人格
"一个端不稳相机的人拍的",比"handheld"强十倍。
21 · 台词逐字锁
标"念到最后一个字才算完成",并规定"硬切只切画面,不切台词"。
22 · 遮挡代替特效
变形、换装、换个演员 —— 用后背、柱子、车身挡住,中间过程不给看。
23 · Re-coverage
把已有动作当 @video_1,只换机位重拍一遍,得到"多机位"素材。
24 · Forward Extend
从最后一帧续 10 秒,逐项保持位置/握持/光/服装。
25 · 接缝藏在运动里
甩镜、身体遮挡、前景扫过、切黑、声音桥 —— 五种,按场景选。
② 锁的优先级:光 > 身份 > 位置 > 焦段(观众最先察觉的是光变了);
③ 表演给任务,不给形容词("眼里找火花" > "眼神深邃")。
10四个官方 Skill:全文中文版
原文里挂了四个可下载的附件。它们才是这套工作流真正的"发动机"—— 提示词的语法、表演的写法、打斗的编排、镜头的质感,各由一个文件规定。我把四个文件全部下载、解包、读完后,逐条译成了中文。
.skill 是什么
它其实是一个 ZIP 压缩包,解压后是一个文件夹,里面至少有一个带 YAML 头的 SKILL.md(name + description),可能还有 references/ 参考资料。放进 Claude 的 skills 目录后,Claude 会根据 description 里的触发词自动加载它 —— 你说"写一场戏",它就用五要素引擎;你说"打斗",它就调用 JKD 编排。
四个文件的体积差得很远:提示词引擎 14KB、表演 12KB、变形镜头 6KB,而打斗那一个解压后 504KB(含 8 本李小龙著作、23 个教学视频、4 本咏春拳谱的摘要)。
① higgsfield-prompt-engine · 五要素戏剧引擎14,045 字符
它解决什么:写戏 / 审戏。作者用它来判断"这场戏到底成不成立",以及把方向扩写成场景提示词。
五个元素(作者自定义,不是教科书定义)
1. 目标(Goal) —— 主角唯一不变地在争的东西:把已经建立的问题修好,并以最快速度抵达能解决它的结果。"已经建立"指任何早先埋下的东西:深层背景、几场戏之前、甚至一分钟之前(上一场带进来的臭味,也算"这一场要修好的过去")。
- 主目标永不变。主角在目标上从不出错。
- 每一场的目标都必须是通往故事目标链条上的一环。测试法:如果删掉这场戏、通往故事目标的链条依然成立,那这场戏就过不了"目标"这一关。没有孤儿戏。
- 主角可以错 —— 但只错在战术上,绝不错在目标上。
- "他应该怎么做"不是单独一项。正确的动作由障碍 + 赌注决定:世界让正确动作变得不可选(他一身臭味就没法去提案,前台会拦住他)。如果赌注不同(生死关头),同一个障碍(脏)就不再重要,他会跳过那一步。所以"正确的战术"= 障碍与赌注逼出来的那一个。若主角选了赌注撑不起来的战术(楼在烧他还去洗澡),要么是写坏了,要么是刻意的自我破坏 —— 要指名是哪一种。
2. 障碍(Obstacle) —— 一个危及某一段路径或整个目标的强情境。它是威胁,不是仅仅花费。它让某一段(或整个目标)有失败的风险。
- 它可以是分支式的搜索空间(一堆文件夹要翻、时间、耐心、专注、没人打扰),也可以是一堵硬墙(电池没电 —— 死的机器搜不了)。一堵硬墙通常会生出一个新的子目标,带自己的地形(找充电器 → 家里没有 → 出去买/借)。
- 障碍有两个尺度:局部(危及当前这一段 —— 臭味危及提案这一段)或全局(危及整个目标)。永远要指出是哪一个。
- 障碍是逼主角选择或改变战术的东西。没有危机 → 不需要战术 → 没有戏。
- 审查测试:说清楚什么在被危及、在哪个尺度上。如果没有任何东西真的处于风险中,这个障碍是假的,戏就会松掉。
3. 战术(Tactic) —— 威胁逼主角选择的那个动作:基于他当前(常常不完整的)知识做出的合理猜测。这是不确定下的搜索,不是"犯错=蠢"。
- 一个"错的"战术不是愚蠢,而是对一个他看不全的空间所做的合理试探(去"图片/家庭"里找照片 —— 没有;现在他知道那儿没有)。主角误读了障碍、输入输出、或处境;他看不到真相会揭示什么。这个引擎的燃料是知识/真相的落差:他相信的,和实际是的,之间的距离。
- 每一次失败的战术都必须带回信息,缩小搜索范围并改变下一步。戏是"缩小"的过程,不是惩罚。
- 审查测试:
✅ 好:以他当时的信息看,这是个合理的赌注,而且它的失败让他(和观众)知道了新东西。
❌ 弱:一个他没理由尝试的战术,或者一次零信息的失败(他什么也没学到,搜索没有缩小 —— 原地打转 / 重复翻同一个文件夹)。 - 失败的战术只有在"什么都没教、没有修正、不改变下一步"时才是弱点。
4. 反转(Reversal) —— 违背预期的转折。三种形态:
- 我自己的动作反噬我 —— 我为了某事做的动作,开始反过来对那件事不利(洗澡为了提案 → 洗澡让我迟到、错过提案)。
- 隐藏的能动性被揭示 —— 我以为我在作用的那个东西/人(或看起来中立的),其实一直在作用我,为我或反我(买家一直在设计我的失败 / 暗中力挺我)。这是惊悚片的招,常在真相落差闭合的那一刻引爆。
- 一般情形:局势转向战术意图的反面。
- 放置规则:每个序列至少一次反转,可以更多。单场戏可以是纯升级;但一个已解决的序列里零反转 = 失败。
- 序列 = 从某个危机(危及某一段/子目标的障碍)打开到它解决(被克服,或它击败了他、逼出新路径)之间的那一段戏。"路径的一段"= 一个子目标,由危及它的障碍定义 —— 两种说法是一致的。
- 序列会嵌套(电池没电生出"去买充电器",那是一个小序列)。每个解决单元都需要自己的反转。要标明尺度:完整的子目标序列,还是它内部的子序列。
5. 价值转移(Value Shift) —— 反转引发的、观众对某个角色的读解的改变。这是拱心石,也是最被误解的一项。它不发生在纸上,发生在观众脑子里。
- 每一次反转都迫使观众重新评判这个角色。一个主角跨反转的弧线示例:好人 → 有经验的人 → 狡猾 → 不,他是绝望 → 孝顺的儿子 → 他是个孩子 → 这才叫男人 → 什么叫男人。任何角色都一样(反派:和善的老人 → 残忍 → 慷慨的生意人 → 混蛋 → …)。它是一个不断被修改的判决。
- 核心规则:没有价值转移的反转是惰性的。一个结构上的转折,除非它推动了观众对角色的判决,否则不算反转。如果你说不出判决前和判决后,那这个反转就是死重量,无论剧情翻了多少。
- 一个序列内的多次转移应构成有设计、递进加深的弧线,不是随机翻烙饼。要审轨迹,而不只是每场有没有。
完整因果链(当作一切的主轴)
目标(固定的引擎;每一场都是通往它的因果一环)
→ 障碍(危及某一段或整个目标的强情境;说清危及什么 + 尺度)
→ 战术(威胁逼出来的动作;基于当前知识的合理猜测;其结果必须带回信息并改变下一步)
→ 反转(违背预期:我的动作反噬我,或隐藏能动性被揭示;每个序列 ≥1 次)
→ 价值转移(反转迫使观众重新评判角色;没有价值转移 → 反转无效)三种模式
- AUDIT(审):用户给了现成的戏/序列/大纲/剧本,要诊断。
- WRITE(写):用户要你写一场戏、给一个方案、或共同创作。
- CO-WRITE(合写):来回迭代,一边写一边持续跑审查逻辑。
AUDIT 的流程(按链条顺序走)
- 目标:一句话说出这场戏的目标。它是通往故事目标的因果一环吗?用"删除测试"。(不知道故事目标就先问 —— 没有它无法完整审"目标"。)
- 障碍:命名那个强情境,并说清它危及什么、在哪个尺度。没有真实风险 → 标记为松弛。
- 战术:找出战术。它是在他当前知识下的合理猜测吗?是被危机逼出来的吗?结果是否带回信息并改变下一步?标记"原地打转"和"无动机战术"。
- 反转:定位序列里的反转,属于哪种形态。确认每个已解决序列 ≥1 次。是零 → 判失败。
- 价值转移:对每一次反转,说出观众的判决前 → 判决后。说不出来 → 这个反转是惰性的(标记为最高优先修复项)。然后评估整个序列的轨迹:是设计好的加深,还是随机摇摆?
AUDIT 的输出格式
戏/序列:<一行识别>
链条检查
• 目标 —— <判断 + 一行理由>
• 障碍 —— <危及什么 + 尺度 + 判断>
• 战术 —— <是否被逼出来?合理猜测?带回信息?判断>
• 反转 —— <形态 + 有无?序列内 ≥1?判断>
• 价值转移 —— <每次反转的 判决前→判决后;或"惰性";轨迹备注>
最弱的一环:<修好它收益最大的那一个元素>
如果……
1.(最小改动 —— 保留用户版本)<只改最弱那一个点,其余照旧成立>
2.(干净版本 —— 完全成立)<即使偏离更多>
3.(可选 —— 只有真的加分才写)<……>WRITE 之前必须先能说出五件事
场景目标(作为通往故事目标的因果一环)、障碍与它危及什么(+尺度)、被逼出来的战术(且会带回信息)、序列里至少一次反转(说出形态)、每次反转带来的价值转移(判决前 → 判决后)。
如果用户还没给故事目标或类型/主题,简短问一句 —— 你需要故事目标来保证"每场都是因果一环",也需要类型/主题来定调(这个 skill 默认服务心理剧/惊悚)。
输出格式(Final Draft 剧本体)
- 场标全大写:
内景/外景 地点 - 时间 - 动作描述用现在时、左对齐。
- 角色名全大写,单独一行。
- 台词在角色名下方。
- 括号提示用
(小写)单独一行,必要时才用。 - 保持干净 —— 除非用户在写编号稿,否则不要场号。
② higgsfield-acting-skill · 让脸"活"起来11,727 字符
它解决什么:AI 生成的人"眼神死、表情空、演得假"。这个 skill 给的不是"更有情绪的词",而是给眼睛一个任务。
核心原则
所谓表演任务,是角色投入到他的战术里去达成目标。
- 它不是外部行为描述("眼睛一闪""眉毛抬起""他看起来很悲伤")—— 那叫演结果,只会产生死脸。
- 它不一定是肢体动作。战术完全可以只活在眼睛里:被羞辱时 vs. 乞求时,是同一种"看",但完全不同;一个凭信念争论的人,会不断检查对方两只眼睛,找一点信任的火花,判断对方是感兴趣还是在走神 —— 然后根据看到的东西调整。
- 眼球的运动本身就是"做"。活 = 心智在任务上逐刻地工作。
- 永远不要用打光技巧(眼神光)去修死眼。给眼睛一个任务。
阶梯(严格按顺序走)
第 0 步 · 先把整场对白读完。绝不从一句台词建任务。任务活在整段交流里 —— 哪里守住了、哪里崩了。在给任何人做指导之前,先检查每个人的每一句。
第 1 步 · 这场戏的目标 —— 一个共享的方向。一场戏只有一个目标:所有人共同朝之的一个方向,通常不用说出口 —— 一种关于"这一次要怎么过"的默契。例子(母亲给儿子收拾行李,一小时后入伍):这场戏的目标是让它不痛 —— 藏住情绪,别让彼此带着痛分别,永远别丢掉那点正向。它同时属于两个人。
这场戏的目标不是影片的戏剧功能(那个揭示、那个主题)。角色从不知道、也从不演影片的目的 —— 那些是透过他们完成的副产品。
第 1a 步 · 结尾命名了事件。先看这场戏怎么结束,再给事件命名。最后一句/最后一个节拍,是你反读整场戏的钥匙。注意那种双关的收尾台词 —— 说着一件事,指的是另一件("可怜的家伙。就是不肯原谅自己" —— 看着病人说,说的是自己)。
第 1b 步 · 所有人都在这一个事件里。事件必须包含场上每一个角色 —— 包括沉默的、无意识的 —— 作为同一个过程的参与者或镜像。如果有谁被排除在事件之外,说明事件命名错了。
第 1c 步 · 物理动作是通道。戏的表面活动("地形"—— 例如例行查房、收拾行李)保留为物理动作,每个角色透过它去追那个事件,各自用自己独特的、可见的肢体行为。看不见的任务必须有一个摄影机读得到的物理通道。
例(事件="寻求自我原谅",物理动作="例行查房"):
- Alfie —— 透过回忆:被接进那一天的重演(闭着的眼皮下快速眼动、一滴泪)。
- 医生 —— 透过把该做的动作做对:正确、准时、精确地写指标,甚至会复核一条记录 —— 看得出他是靠"零差错流程"维持自己还是个医生;把每件事做对,是他仅剩的医者身份。
- 实习医护 —— 透过照护:清单之外的动作(看的是人,不是表格)。
规则:给场上每个角色一个属于他自己的物理通道 —— 不同的行为,同一个事件,同一块地形。
第 2 步 · 每个人的动机 —— 不同的燃料,同一个方向。所有人都朝同一个方向推,但各自为自己的理由。儿子"为了妈妈"让这次不痛;母亲"出于迷信"(出行前流泪是坏兆头)。同一支箭,不同的燃料 —— 燃料决定每个表演的独特性,同时让整场戏读起来统一。
动机可以是几个备选假设,由导演来选。给定情境会约束动机:一个在实验性囚犯实验室上班的人本来就已经被妥协了,他不可能演出道德上的无辜。
第 3 步 · 每个人的目标 —— 属于他自己的那场仗。从动机里长出来:他在这场戏里为自己争什么。要普通、个人、可演。永远不要和"这场戏的目标"用同一句话,永远不要是主题。
第 4 步 · 障碍 —— 顶着方向压过来的东西。那个威胁要弄断这场戏的线的东西(真实情绪正往表面顶;这个案子太可怕,没法保持例行)。一道裂缝,共享的目标就塌了。观众真正感受到的正是这股压力 —— 恰恰因为没人去演它,所有人都在演"把它挡在外面"。
第 5 步 · 战术 —— 真正意义上的表演任务。把投入的、逐刻的追寻写出来,写成他对对手"做"什么,并明确把眼神工作写成有目的的动作:
- 检查对方两只眼睛里有没有一点信任的火花
- 每说完一点就登记一次:落到了吗?感兴趣,还是快要冷笑?
- 偷看他,在他发现之前把目光收回来
- 打量他、记住他、把自己感觉到的和他表现出来的做比较
节拍要挂在真实台词的字上。需要时标出"燃料烧完、线断掉"的那个点(实习医护低声那句"可怜的家伙" —— 那个断裂本身就是这场戏的交付)。
在提示词里写 ACTING TASK 块
表演任务 —— <角色名>(他完全投入在自己的战术里;工作发生在眼睛里):
场景方向(共享、不说出口):<一行>
动机(他的燃料):<他为什么推这个方向>
目标:<他为自己争什么>
障碍:<顶着这条线压过来的是什么;一道裂缝会失去什么>
战术:<他对对手做什么,以及眼神在检查什么>
逐刻:
— 「<台词>」—— <对对手做的动词> + <眼睛在查什么>
— 「<台词>」—— <动词> + <眼神工作>
— <如果线断了,断在哪>
(安全线:目光始终在任务上 —— 绝不出现僵死、空洞、失焦的凝视;保持自然的眨眼节奏,人会眨眼来润湿眼睛。)写作规则
- 动词指向对手;不要把情绪形容词当指令("悲伤地""紧张地")。
- 不要面部编排("眉毛抬起""嘴唇颤抖")—— 外部描写只留上面那条安全线。
- 没人演情绪,所有人演方向。观众通过压力接收到感受。
- 允许并建议留一条防"僵死凝视"的安全线(AI 模型的必需品)。
- 画面里每个角色都用这个方式获得活的眼睛 —— 包括沉默的听者:听者的任务也是真的("判断他是不是认真的""等那个包袱""保护这个气氛")。
对照配对:双人戏建立在镜像的 +/− 上
两个人各拿一个加号和一个减号,与对方镜像,其中一条轴是观众真正在读的那条本质轴。
- 医生 —— 忠于公司(+)/ 漠不关心(−):他确实忠诚,但忠于公司和钱,不忠于病人。他的加号(忠诚、勤勉、专业)侍奉错了主人。在本质轴(对病人的照护)上,他是减。
- 实习医护 —— 被妥协(−)/ 有照护心(+):他被公司和钱妥协了(他接了这个工作,他知道这是什么地方),但对病人有照护心。他的减号是真的,他的加号在减号内部存活。本质轴上他是加。
规则:每人一个 + 一个 −,与对手反向;命名这场戏的本质轴;两人仍朝同一个方向推 —— 对比活在共享方向之下,通过战术和眼睛漏出来。表面特质常常是它反面的疤痕:"漠不关心"= 希望早已丧失,不是"没有关心"。要导的是历史,不是表面。
常见失败(审查清单)
- 任务建立在单句台词上,而不是整段对白 → 先重读整场。
- 把影片的揭示/主题当成角色的任务 → 角色从不演影片的目的。
- 把"这场戏的目标"和"角色的目标"搞混 → 前者是共享方向,后者是各自私人的。
- 动机无视给定情境(明明已经同谋,却演无辜)→ 重新推导动机。
- 用"面部编排"代替"眼神作为有目的的动作" → 改写成指向对手的动词。
- 把情绪形容词当指令 → 换成能产生该情绪的任务。
③ higgsfield-fight-scene · 截拳道打斗编排解压后 504 KB
它解决什么:让 AI 生成的打斗像真正的截拳道,而不是"抡胳膊的功夫片"。这个 skill 不负责提示词格式(格式交给提示词引擎),它只负责打斗的内容。
为什么它这么大
解压后是一个知识库 + 摘要库,作者把李小龙的 8 本书、23 个教学视频、4 本咏春拳谱全部消化成摘要:
higgsfield-fight-scene/
├── SKILL.md 主文件(编排流程与校验清单)
└── references/
├── jkd-core.md 原则、站架、步法、距离、五种攻击法
├── moves-catalog.md 招式词典(别名 → 标准动作 → 英文片段 → 反应)
├── techniques.md 具体打击与截击:名称、机制、可辨识的视觉特征
├── choreography-patterns.md 现成的节拍模板(截击、一对二、刀、陷阱连招)
├── styles/wing-chun.md 第二种拳种:咏春(正面窄马、黏手、连环拳)
└── sources/
├── INDEX.md 资料索引
├── 01-tao-of-jkd.md 李小龙《截拳道之道》
├── 03–04-fm1/fm2… 《格斗术》系列
├── 13–16-wc1/wc2… 咏春(刘为汉 1–3 级、叶准 116 式木人桩)
└── video/ · video-wc/ 视频教程逐条拆解工作流(五步)
- 拆场景:确认打手、对手数量、武器、地点、情绪、镜头时长、谁赢。如果用户点名了招式,就查
moves-catalog.md(别名 → 标准动作 → 英文片段),并保留用户给的顺序。 - 读知识库:
jkd-core.md+choreography-patterns.md+ 相关摘要。摘要优先于基础文件,因为它们反映作者对这一派的理解。 - 按节拍编:把打斗切成 1–2 秒的节拍。每个节拍包含:位置 → 动作(哪只手/腿、什么技法、打哪里)→ 对手的物理反应 → 新位置。截拳道的逻辑是:截击而不是格挡、走最短的线、用最小动作。
- 翻成提示词语言:具体的肢体与目标、具体措辞、无预备动作、以秒计时。
- 验真:过下面的清单。
交付前的真实性清单(九条)
- 用身体几何在首帧定义站架,而不是用术语(模型不知道"摆桩"是什么)。
- 至少一次截击:这一派的定义性逻辑是"截",不是"挡了再还手"。
- 踢腿保持在腰以下,用正向约束写:"每一次踢腿都停在腰带高度以下。"
- 用正向写法消除预备动作:"肢体第一个可见的动作就是打击本身,从它在防守位的位置直接发出。"
- 用断裂节奏:爆发 → 完全静止 → 爆发。把"静止"写成一个状态。
- 节约:2–4 个节拍解决战斗。
- 每一次打击都要写明:肢体、轨迹、目标、对手反应的物理。
- 把武术术语和禁止项挡在提示词正文之外("命名即召唤")。结尾加一个
FIGHT STYLE LOCK。 - 不常见的招式需要三重锚:一个日常视觉类比(反手一巴掌 / 网球反手 / 驴踢 / 踹门)、一个明确的击打面(先碰到的是什么、掌心朝哪)、一个沿打击方向的靶向反应(反背拳会把头横向甩开)。
数据不会骗人:为什么"无预备动作"必须写
文件里记了一条作者的血泪教训(v1.5):
- "反背拳(backfist)被模型理解成了普通直拳" —— 因为"拳"这个词会激活直拳先验。
- 凡是"不常见"的打击,模型都会退回到它最熟悉的那个动作。所以必须用日常类比 + 击打面 + 靶向反应三重锚把它钉住。
改写的示范:弱 → 强
弱(通用写法)
"主角用武术动作打退了袭击者。"
强(几何 + 无术语 + 无禁止项)
"他几乎侧身站着,右肩与右脚在前,后脚跟离地,重量轻轻落在前脚掌,前手在肩高半伸。"
// 完整节拍(意译):把"位置→动作→反应→新位置"写进一句话链
他几乎侧身站着,右肩与右脚在前,后脚跟离地,重量轻轻落在前脚掌,前手在肩高半伸。
袭击者的肩膀刚开始蓄力抡一个大右摆 —— 就在那一瞬间,主角的前手拳已经落到他的下巴上,
从它在防守位悬停的地方出发的一条直线,一个短促的滑步把体重送进去。
袭击者的头向后甩开,踉跄两步撞进垃圾箱。
主角收回窄侧身站架,完全静止。INGEST:知识库怎么长大
- 从新材料里抽出:技法、原则、组合、时机、常见错误、视觉细节(在镜头里长什么样)。
- 写成结构化摘要放到
references/sources/NN-短名.md,含来源、关键技术、对编舞的影响、可用的原话表述。 - 更新
INDEX.md,一条来源一条记录。 - 如果材料改动了站架、清单、模板这类基础规则,就更新对应参考文件并抬高版本号。
- 把改动展示给用户,重新打包
.skill。
规则:当新材料与旧知识库冲突时,用户给的材料优先,并在摘要里记录这个冲突。
版本史里有三条方法论教训
- v1.4:为了让模型"听懂",把武术术语和禁止项全部移出正文 —— 模型不认识术语,会渲染成通用功夫。
- v2.0:曾经引入一套"五阶段冲击引擎",结果生成质量变差。结论很硬:臃肿的提示词会让关键事实丢失。后来回滚了。
- v2.4:动漫插入镜头整块被移除(移到另一个专门的 skill),说明作者在严格做"一件事一个 skill"。
④ anamorphic-look · 变形宽银幕的写法6,137 字符
它解决什么:你在提示词里写"anamorphic",模型给你一张普通照片,只是旁边多了个词。这份文件的核心判断是:
模型不听镜头名字,它听镜头的视觉证据。
1. 先按活儿选焦距
| 用途 | 焦距 | 对角视场 | 为什么 |
|---|---|---|---|
| 地点 / 定场 / 地理关系 | 24mm | ≈84° | 地点默认;房间读得开、纵深叠得起来 |
| 地点 + 有主角物件或纵深层次 | 35mm | ≈63° | 虚化还能用,边缘拉伸更少 |
| 狭窄内景、窄街、车内 | 40mm | ≈57° | 24mm 会撞墙的时候用 |
| 中景 / 表演 | 50mm | ≈47° | 脸还能读 |
| 肖像 / 插入镜 | 85mm | ≈29° | 绝不要用 24mm 拍脸 |
铁律:脸永远不用 24mm —— 会拉变形。角色板:85mm(肖像)、50mm(全身)、35mm(群像)。
给视频模型写视场角度数,不要写毫米:对角视场 84°,变形宽银幕直线透视。整镜焦段锁死。
2. "强虚化"必须锚在物理上
只写"强虚化"在广角上什么也不会发生。24/35mm 的虚化只在两件事同时成立时存在:摄影机离前景主体很近,且光圈全开。所以永远要写四样:
- 焦点 —— 一个具体物件:
焦点锁在最近的那条白线上 / 那把椅子上 / 第一根柱子的边缘。 - 距离 ——
摄影机距焦点 1–3 米,镜头在膝/腰/胸高。 - 光圈 ——
全开。 - 什么化开 —— 点名层次:
前景的 X 化成一团奶油般的虚化,远处的 Y 溶成柔焦。
没有点名的焦点,模型会把一切拍实。
3. 把焦外和耀斑写成"物体"
变形宽银幕焦外:在湿地面 / 水洼 / 灯泡 / 窗光上呈现竖向拉长的椭圆光斑,
并从画面里最亮的那个光源拉出一道长条横线蓝色耀斑。- 光斑是竖椭圆(上下拉长),不是圆的。
- 耀斑是横向的,通常是蓝色;要点名它来自哪个光源。如果画面里只有暖光(钨丝灯、火),就写"暖橙色横条耀斑" —— 钨丝灯拉出蓝耀斑,一眼假。
- 画面里没有亮源 → 没有耀斑。先给画面一个高光(一盏灯、一道天际线、一片湿地反光),耀斑才有理由存在。
4. 胶片:只写平衡与感光度,不写厂家
| 场景 | 写法 |
|---|---|
| 夜、内景、黄昏、钨丝灯 | 钨丝灯平衡 500 度彩色负片颗粒 |
| 日光、阴天、阳光、柔调 | 日光平衡 250 度彩色负片,细颗粒 |
5. 技术尾(每个地点提示词都挂)
实拍 35mm 胶片,钨丝灯平衡 500 度 / 日光平衡 250 度彩色负片颗粒;
变形宽银幕 24/35/40mm 镜头,轻微水平耀斑与柔和的高光晕;
三分法构图;自然的真实色彩;真实的环境物理 —— 灰尘 / 薄雾 / 雨 / 飘动的烟 / 水洼涟漪;
粗粝的纪录片式真实感,与真实照片难以区分,完全没有 CG 或渲染感。
没有克隆或重复的元素。干净的环境板,画面里没有人。没有文字、没有水印、没有标志。画幅 2.39:1。雨只有在被灯或霓虹背光、并形成可见的条状时,才读得出来 —— 要写明这一点。
6. 机位锚点
3/4 斜角,摄影机置于空间一侧、斜着看进纵深 / 横过房间,
镜头在膝 / 腰 / 胸高度(必要时微微上仰)。一台机、空间的一侧、一个高度。正是这个 3/4 斜角让变形宽银幕的纵深层次读得出来。
7. 画幅
默认 2.39:1。自然语言模型:在结尾用文字写 画幅 2.39:1。,同时在界面上也设一次。支持参数旗标的模型:加对应的 21:9。
8. 地点提示词的组装顺序
电影剧照。+ 一行地点 + 情绪- 机位锚点(角度、哪一侧、高度)
- 画面里有什么,前景 → 背景
- 调色比例 60/30/10
- 光线(来源、色温、方向、对比)
- 焦点 + 光圈 + 什么化开 + 光斑/耀斑的对象
- 技术尾
9. 失败修复表
| 症状 | 修法 |
|---|---|
| 一切都实 | 点名焦点,把机位放到距焦点 1–3 米,写"光圈全开" |
| 光斑是圆的 | 写"竖向拉长的椭圆高光",并点名它们落在什么上 |
| 没有耀斑 | 在画面里加一个亮源,并点名从它拉出的那道横条 |
| 鱼眼 / 桶形畸变 | 加"直线透视",退到 35mm |
| 脸被拉变形 | 你用了 24mm 拍人 —— 换 85/50 |
| 像 3D 渲染 | 保留技术尾:真实 35mm 胶片 + 颗粒 + 环境物理 |
| 暖灯上出现蓝耀斑 | 把耀斑改成暖橙色,与光源匹配 |
| 冒出品牌 logo | 你在某处写了产品名 —— 换成对"外观"的描述 |
10. 关于负面词
- 自然语言模型:把"要移除的"写成正向(用
边缘到边缘色调均匀代替没有渐变)。技术尾里自带的没有克隆… 没有文字…是唯一被允许的例外。 - 支持负面参数旗标的模型:负面旗标最多 3–5 个单字词。
11翻车与修复对照表
下面每一条,都是这套流程里"一定会遇到"的问题,以及原文给出的解法。存成书签,出事时照着查。
| 症状 | 根因 | 修法 |
|---|---|---|
| 下一个镜头换了张脸 | 只用图片元素,且没人写"不许变" | 升级成视频元素;加 IDENTITY LOCK;多人同框时写相对身高差 |
| 光忽然变了 | 没有光锁,模型每个镜头重新打光 | LIGHT LOCK — ABSOLUTE:光源清单 + 色温 + "不得新增光源、不得整体提亮" |
| 房间越拍越不像 | 每镜都在自由生成空间 | 先做无人的空景板;加 LOCATION MAP;首帧给坐标 |
| 人像滑冰 | 没有 PHYSICS 段 | 写重量:重心在哪条腿、落地弯膝、布料甩动、鞋底与湿地的抓地 |
| 人群是一堆贴纸 | 只写了"人群" | QUALITY 里写"每个人都是不同的人、不同颜色、有自己的动作;没有克隆脸、没有融合身体、没有重复四肢" |
| 台词被剪掉半句 | 模型为了节奏自己切 | DIALOGUE — VERBATIM:逐字锁定 + "念到最后一个字才算完成" + "硬切只切画面,不切台词" |
| 眼神死、脸像面具 | 在用形容词指挥情绪 | ACTING TASK:给眼睛一个任务(检查对方眼里有没有信任的火花),并留一条防僵死的安全线 |
| 打斗像抡王八拳 | 用了"武术"这种抽象词 | 写身体几何 + 无预备动作 + 2–4 拍解决 + 每次打击写清肢体/轨迹/靶点/反应 |
| 广角却毫无虚化 | 只写了"强虚化" | 点名焦点 + 距焦点 1–3 米 + 光圈全开 + 点名什么化开 |
| 变形/换装过程很怪 | 让模型画中间帧 | 用后背/柱子/车身挡住;镜头再打开时已经是完成体 |
| 一眼 CG | 缺技术尾 | 挂技术尾:实拍 35mm 胶片、颗粒、环境物理、无渲染感、画幅 2.39:1 |
| 30 秒里塞了一整部片 | 模型以为这是完整的短片 | SCENE CONTEXT 第一句写"第 N 块,共 M 块",并写明"本块结束在什么状态" |
| 两个镜头接不上 | 屏幕方向反了 / 首帧位置没写 | LOCATION MAP 写清"摄影机在哪一侧、人物往哪边走";首帧给 x/y 百分比 |
| 一条只能出 20 秒,戏没演完 | 被单条时长卡住 | 分两条拍,接缝藏在甩镜/遮挡里;或用 Forward Extend 续 10 秒 |
12跟练:七天,从零到一条 60 秒
不要一上手就拍五分钟。按下面这个顺序,每天只解决一件事,第七天你会拥有一条真正能看的片段。
Day 1 · 装好工具与命名
- 四个 skill 解包,放进 Claude 的 skills 目录(
SKILL.md的description里就有触发词)。 - 写下你的命名表:
@char_A_video_v1、@loc_room_v1、@prop_gun。之后所有对话都用这套名字。 - 产出:一份 ≤10 行的命名表。
Day 2 · 一张角色板
- 用自己或朋友的照片,按"双联画"格式做一张。只改一件事:把发型换掉。
- 检查:两格是同一个人吗?灯是同一盏吗?背景是同一块吗?
- 产出:2 张图(卷发 / 直发)。
Day 3 · 去 AI 味 + 视频元素
- 找 4 张材质参考(头发、皮肤、背景、布料),做一次"只修右格"的精修。
- 录一句 5 秒台词,做一段视频元素。反复三次,直到脸和声音都对得上。
- 产出:1 张精修图 + 1 段约 10 秒表演参考。
Day 4 · 一个空房间,两面
- 做一张空景板(没人、机位写死、光可复述)。
- 用它做一张"只重打光"版,再做一张反打。
- 产出:3 张图(冷光 / 暖光 / 反打)。
Day 5 · 第一条真正的镜头段(15 秒,3 个镜头)
- 严格用 15 段骨架填空,宁可空着也别省段落。
- 只写 15 秒 —— 短,才看得清哪一段在起作用。
- 产出:1 条 15 秒片段 + 你写的第一份完整提示词。
Day 6 · 打斗 2–4 拍 + 换覆盖
- 只编 3 个节拍:截击 → 接触 → 反应。每拍写明肢体、轨迹、靶点、反应。
- 拿这条打斗当
@video_1,换一个更低更广的机位重拍一遍。 - 产出:同一段打斗的两个机位。
Day 7 · 拼一条 60 秒
- 把 Day 5 的镜头段 + Day 6 的两个机位 + Day 4 的空镜,剪成 60 秒。
- 刻意练一件事:用甩镜 / 遮挡 / 切黑,把三处接缝藏起来。
- 产出:一条 60 秒的完整片段。发出去,然后第二天重来一遍 —— 第二遍会快三倍。
13术语与出处
| 术语 | 一句话解释 |
|---|---|
| Element(元素) | 被命名、可 @ 引用的资产(角色/地点/道具),分图像与视频两种 |
| Plate(板) | 空的环境画面,只给布局、材质、光,不给动作 |
| Take(条) | 一次生成得到的片段;一条提示词通常出 1–3 条可用素材 |
| Lock(锁) | 提示词里"不许变"的段落:光锁、身份锁、位置锁、风格锁 |
| FOV | 视场角(度)。用角度写焦距,视频模型才听得懂 |
| Re-coverage | 沿用已有动作,只换机位重拍一遍 |
| Forward Extend | 从一条视频的最后一帧继续生成 |
| Diegetic sound | 画内声:故事世界里真实存在的声音(不是配乐、不是旁白) |
| POSITIVE CONSTRAINTS | 正向约束:只描述"允许发生什么",不写"不要什么" |
| Skill | 打包好的指令文件(ZIP + SKILL.md),Claude 按 description 自动加载 |
原文与附件
- 原文:How to Make a Cinematic AI Short Film — @adilinthewildtempo / Higgsfield(发布于 10 月 24 日,标注 9 分钟阅读)
- 四个附件(原文页内可下载):
higgsfield-prompt-engine.skill·higgsfield-fight-scene.skill·higgsfield-acting-skill.skill·Anamorphic skill.md - 本报告中的 36 条提示词统计、段落命名、场景时长,均来自对该页面的实际抓取与解析;四个 skill 的正文来自附件解包后的
SKILL.md。
14附录 · 素材库
全部素材都在这一个页面里,离线也能看。上面正文里已经按剧情位置贴过一遍,这里集中放一次,方便你对照参考。
18 段视频(点击即播)
14 张图(角色板 / 空景板 / 重打光 / 反打 / 走位图)